Category: IT

  • Catatan Belajar Proxmox: Memahami Advisory PinTheft (PSA-2026-00022-1)

    Catatan Belajar Proxmox: Memahami Advisory PinTheft (PSA-2026-00022-1)

    Halo teman-teman, di post kali ini saya mau share catatan belajar yang baru saya dapat terkait Proxmox. Tepatnya soal security advisory yang dirilis tim Proxmox tanggal 19 Mei 2026 kemarin.

    Belakangan ini saya memang sedang fokus mendalami Proxmox VE dari berbagai sisi, mulai dari cluster setup, Ceph, ZFS replication, sampai topik-topik advanced lainnya. Kebetulan Pak Ahmad Imanudin, lead engineer di PT. Excellent Infotama Kreasindo, kasih link forum advisory Proxmox dan bilang ada update security yang patut dipelajari. Setelah saya baca, isinya cukup menarik dan saya pikir worth banget di-dokumentasikan di blog ini sebagai catatan pembelajaran.

    Post ini hanya merupakan penjelasan saja sebagai catatan belajar saya pribadi. Jadi, bukan panduan mitigasi atau eskalasi nya. Saya bukan ahli security, jadi kalau ada teman-teman yang lebih ahli dan ada bagian yang salah, mohon koreksi di kolom komentar.

    Apa Itu Security Advisory di Proxmox

    Hal pertama yang baru saya pahami adalah cara Proxmox merilis security advisory. Mereka secara berkala publish di thread forum resmi mereka. Format penomorannya seperti ini:

    PSA-{tahun}-{nomor-urut}-{revisi}

    Misalnya PSA-2026-00022-1 artinya advisory nomor 22 di tahun 2026, revisi 1.

    Konten advisory biasanya terdiri dari beberapa bagian. Subject yang berisi codename plus dampak singkat. Affected packages yang menjelaskan package mana yang kena. Details yang berisi penjelasan singkat root cause. Mitigation yang menjelaskan langkah workaround sebelum fix tersedia. Dan Fixed in yang nantinya akan diisi versi yang sudah patched.

    Advisory kali ini membahas codename “PinTheft”, sebuah Local Privilege Escalation di kernel Proxmox.

    Mengenal PinTheft

    PinTheft adalah teknik gabungan dari dua hal itu. Langkah-langkahnya berdasarkan write-up yang saya baca:

    1. Attacker pakai io_uring untuk pinning halaman memori dengan banyak reference.
    2. Pakai bug double-free di RDS untuk “mencuri” reference satu per satu.
    3. Setelah cukup banyak reference dicuri, halaman dianggap free oleh kernel.
    4. Halaman itu dialokasikan ulang sebagai page cache untuk binary SUID-root, contohnya /usr/bin/su, /usr/bin/passwd, /usr/bin/pkexec, atau /usr/bin/mount.
    5. Pakai pointer io_uring yang sudah stale, attacker overwrite isi binary itu di memori dengan payload ELF kecil.
    6. Begitu binary SUID dijalankan, attacker dapat root shell.

    Jadi kombinasi dua bug yang masing-masing terlihat “kecil” bisa jadi exploit chain yang serius kalau digabungkan. Ini pelajaran penting tentang attack chaining yang sering dibahas di security research.

    Konteks Local Privilege Escalation (LPE)

    Bagi yang belum familiar dengan istilah LPE, ada dua kata yang perlu dipahami. Local artinya penyerang sudah punya akses ke sistem, entah user SSH biasa, kompromi akun service, container escape, atau code di VM yang lolos isolation. Privilege Escalation artinya naik dari user biasa jadi root.

    Jadi LPE tidak bisa diserang dari internet langsung, butuh foothold dulu. Tapi di lingkungan multi-tenant atau yang banyak service running, foothold itu sering lebih mudah didapat daripada yang kita kira. Itulah kenapa LPE tetap dianggap serius meskipun bukan remote.

    Yang terkena dampak

    Berdasarkan advisory, semua package proxmox-kernel-*. Belum ada versi kernel yang fixed di tulisan advisory ini, Proxmox bilang akan publish advisory follow-up begitu ada fix tersedia.

    Pemahaman Tentang Advisory

    • Pertama, target-nya adalah kernel hypervisor, bukan kernel VM. Artinya yang perlu di-mitigasi adalah Proxmox host, bukan VM-VM di dalamnya.
    • Kedua, dampak root di Proxmox host itu sangat besar. Begitu attacker dapat root di node Proxmox, secara teori mereka bisa akses semua VM, semua storage, semua data. Worst case scenario untuk infrastruktur IT.
    • Ketiga, ada tren yang menurut saya patut dicatat. Ini bukan advisory tunggal. Tanggal 8 Mei 2026 sebelumnya sudah ada advisory PSA-2026-00019-1 codename “Dirty Frag” yang juga LPE via modul kernel yang auto-loaded (esp4, esp6, rxrpc). Pattern-nya sama, yaitu modul kernel jarang dipakai, auto-loaded saat ada request socket family dari user, dan ada bug yang bisa di-exploit untuk LPE. Tren ini kasih saya pelajaran bahwa attack surface kernel yang seringkali tidak kita sadari adalah modul-modul yang bisa di-load otomatis hanya dengan request socket family tertentu dari user biasa.
    • Keempat, PoC sudah publik. Tim V12 Security sudah rilis Proof-of-Concept-nya di GitHub setelah patch upstream tersedia. Artinya secara teori exploit ini sudah bisa diakses publik dan harus segera di-mitigasi.

    Mitigasi yang Disarankan Proxmox

    Bagian ini saya tulis berdasarkan apa yang tertera di advisory. Karena saya masih dalam tahap belajar, saya hanya mencantumkan mitigasi yang disarankan Proxmox. Saran saya selalu sesuaikan dengan environment masing-masing dan baca advisory aslinya langsung.

    Sambil tunggu kernel fix rilis, ada tiga langkah utama yang disarankan Proxmox.

    Langkah pertama adalah cek apakah modul sudah ter-load:

    lsmod | grep -e rds -e rds_tcp

    Kalau output kosong artinya aman, modul belum ter-load. Kalau ada output dan tidak sedang pakai RDS untuk workload tertentu, ini bisa jadi indikasi auto-load atau bahkan upaya exploit, perlu di-investigasi lebih dulu sebelum unload.

    Langkah kedua adalah mencegah modul ke-load di masa depan:

    sh -c "printf 'install rds /bin/false\ninstall rds_tcp /bin/false' > /etc/modprobe.d/pintheft.conf"

    Trik ini menggunakan install directive di modprobe yang me-redirect proses loading modul ke /bin/false (program yang langsung exit dengan error). Hasilnya, setiap upaya load modul rds atau rds_tcp bakal gagal, baik dari root maupun user biasa.

    Langkah ketiga adalah unload modul yang sudah ter-load kalau ada:

    rmmod rds_tcp rds

    Lalu untuk verifikasi mitigasi aktif, bisa coba load manual modul dan lihat outputnya:

    modprobe rds

    Output bakal berisi error karena modprobe sebenarnya ngeksekusi /bin/false, bukan benar-benar load modul.

    Yang menarik, mitigasi ini tidak perlu reboot. Begitu file /etc/modprobe.d/pintheft.conf dibuat dan modul yang sudah load di-unload, mitigasi langsung berlaku.

    Pelajaran yang Saya Ambil

    Dari proses belajar advisory ini, ada beberapa pelajaran yang saya tarik dan ingin dokumentasikan di sini.

    • Pertama, security advisory Proxmox itu tidak digembar-gemborkan di mana-mana. Biasanya cuma di-publish di thread forum mereka. Buat saya yang sebelumnya mungkin tidak rutin mengecek forum, ini reminder bahwa subscribe ke thread advisory mereka itu penting. Linknya saya cantumkan di akhir post.
    • Kedua, mekanisme auto-loading modul kernel ternyata adalah attack surface yang halus tapi serius. User biasa secara teori bisa memaksa kernel me-load modul-modul tertentu hanya dengan membuka socket dengan address family tertentu. Kalau modul itu ternyata vulnerable, jadilah LPE seperti PinTheft ini.
    • Ketiga, defense-in-depth kelihatan makin relevan. Selain apply mitigasi spesifik, audit modul kernel yang tidak terpakai mungkin perlu jadi bagian dari hardening checklist. Modul-modul jaringan jarang dipakai seperti RDS, DCCP, SCTP, RxRPC, dan ESP, atau filesystem driver yang exotic seperti NTFS3 atau JFS, beberapa di antaranya sering jadi vector LPE.
    • Keempat, patch management hygiene jadi makin penting. Begitu kernel fix dari Proxmox tersedia, sebaiknya tidak ditunda terlalu lama. Untuk environment cluster, tinggal migrasi VM ke node lain dulu, baru reboot satu per satu.

    Penutup

    Selain belajar hal baru tentang kernel security, saya juga jadi sadar bahwa banyak hal “low-profile” tapi berdampak besar yang harus mulai dipantau secara rutin sebagai admin infrastructure. Sebelumnya saya kira advisory begini cuma muncul kalau ada CVE besar yang viral di Twitter atau media tech, ternyata ada banyak yang muncul senyap di forum tapi sebenarnya butuh tindakan cepat.

    Mudah-mudahan catatan belajar ini bermanfaat untuk teman-teman yang sedang mendalami Proxmox dan ingin memahami lebih dalam soal sisi security-nya. Kalau ada teman-teman yang lebih ahli dan punya koreksi atau tambahan terkait pemahaman saya ini, bisa komen ya di kolom komentar.

    Sumber:

  • Panduan System Admin Carbonio (Versi Ringkas)

    Panduan System Admin Carbonio (Versi Ringkas)

    Catatan singkat hasil belajar saya selama proses training dan praktik di lapangan. Bukan dokumentasi lengkap, tapi inti yang bisa dipakai sehari-hari.

    Arsitektur singkat

    Carbonio terdiri dari beberapa role utama yang bisa dipasang di satu server atau dipisah di multi-node:

    • Mailbox: tempat data email disimpan, sisi Java/Jetty
    • MTA: Postfix untuk kirim dan terima email, plus Amavis dan ClamAV
    • Proxy: nginx untuk handle koneksi user (HTTPS, IMAPS, POP3S)
    • Directory Server: OpenLDAP untuk identitas dan konfigurasi
    • Consul: service discovery dan health check

    Service-service ini saling tergantung. Di multi-node, urutan startup dan restart penting.

    Service management

    Semua operasi dijalankan sebagai user zextras:

    su - zextras
    # Cek status semua service di node ini
    zmcontrol status
    
    # Restart semua service (handle dependency otomatis)
    zmcontrol restart
    
    # Start atau stop semua
    zmcontrol start
    zmcontrol stop
    
    # Cek versi Carbonio
    zmcontrol -v
    
    # Info core dan environment
    carbonio core core-info

    Untuk service systemd modern Carbonio (untuk carbonio terbaru memerlukan kontrol melalui systemd):

    systemctl status carbonio-*
    systemctl restart carbonio-mailbox

    pending-setups wajib di-cek setelah upgrade atau install komponen baru. Kalau ada langkah setup yang belum selesai, command ini akan ngasih tau.

    Manajemen akun

    Lewat CLI carbonio prov (versi baru) atau zmprov (warisan Zimbra, masih jalan):

    # Masuk ke shell interaktif prov
    su - zextras -c "carbonio prov"
    
    # Buat akun baru
    su - zextras -c "carbonio prov ca user@domain.com password123 displayName 'Nama User'"
    
    # Reset password
    su - zextras -c "carbonio prov sp user@domain.com newpassword"
    
    # Lihat info akun
    su - zextras -c "carbonio prov ga user@domain.com"
    
    # List semua akun di domain
    su - zextras -c "carbonio prov -l gaa domain.com"
    
    # Delete akun
    su - zextras -c "carbonio prov da user@domain.com"

    Untuk domain dan COS (Class of Service), command-nya cd, gd, cc, gc. Detail lengkapnya bisa di-cek dengan help di dalam shell prov.

    Log dan troubleshooting

    Lokasi log utama:

    • /opt/zextras/log/mailbox.log: aktivitas mailbox (IMAP, POP3, autentikasi, index)
    • /opt/zextras/log/audit.log: autentikasi
    • /var/log/carbonio.log: MTA, Postfix, Amavis, ClamAV via syslog
    • /var/log/mail.log: Postfix langsung
    • journalctl -u carbonio-*: service systemd

    Pola umum troubleshooting:

    # Cari error di mailbox.log
    grep -iE "error|fatal|exception" /opt/zextras/log/mailbox.log | tail -50
    
    # Tail log realtime
    tail -f /opt/zextras/log/mailbox.log
    
    # Liat log dalam rentang waktu tertentu
    journalctl -u carbonio-mailbox --since "2 hours ago"
    
    # Debug per-user tanpa restart mailbox
    su - zextras -c "zmprov addAccountLogger user@domain.com zimbra.imap debug"

    Frasa “caused by” di stack trace biasanya pointer ke root cause.

    Backup

    Yang wajib di-backup:

    • /opt/zextras/ untuk data utama Carbonio (mailbox blob, config, LDAP)
    • Database MariaDB (metadata mailbox)
    • LDAP dump untuk recovery cepat tanpa restore filesystem penuh
    • Konfigurasi system di /etc/

    Carbonio Enterprise punya backup native. Untuk Community Edition, strategi umum: snapshot di hypervisor, atau Proxmox Backup Server di level VM, plus dump LDAP berkala via slapcat atau equivalent.

    Cek harian

    Rutinitas pagi yang saya biasakan:

    bash

    # Status semua service
    su - zextras -c "zmcontrol status"
    
    # Mail queue (deferred message di Postfix)
    su - zextras -c "mailq | tail"
    
    # Disk usage partisi data
    df -h /opt/zextras
    
    # Pending setups
    pending-setups
    
    # Liat ada antrian yang stuck
    su - zextras -c "postqueue -p | tail"

    Mail queue yang menumpuk biasanya pertanda ada masalah delivery, baik dari sisi DNS, antivirus stuck, atau penerima yang menolak.

    Penutup

    Panduan ini cuma scratching the surface. Tiap deployment Carbonio punya konteks sendiri, jadi sesuaikan sama topologi yang kalian punya. Tapi untuk operasi harian, command-command di atas udah cover sebagian besar kebutuhan.

    Sampai jumpa di catatan berikutnya.

  • Mendalami Ansible: Tips dan Trik Pemula

    Mendalami Ansible: Tips dan Trik Pemula

    Belajar Ansible dari Nol: Tips dan Trik Supaya Tidak Pusing di Awal

    Saya masih ingat awal-awal jadi admin server, ketika setiap update kecil harus saya kerjakan satu per satu lewat SSH. Bayangkan ada sepuluh server, dan saya harus install paket yang sama, edit file konfigurasi yang sama, restart service yang sama, sepuluh kali. Selain capek, saya jadi rawan salah ketik dan lupa mana server yang sudah dikerjakan.

    Sampai akhirnya saya kenal Ansible, dan semua kerepotan itu langsung berkurang drastis. Di tulisan ini saya ingin berbagi pengalaman belajar Ansible dengan gaya yang ramah pemula, tanpa terlalu banyak command, dan fokus ke konsep serta kebiasaan baik yang menurut saya wajib dipahami sejak awal.

    Apa Itu Ansible?

    Sederhananya, Ansible adalah alat otomasi. Kalian tulis sekali apa yang ingin dilakukan di server, lalu Ansible yang akan menjalankannya ke semua server tujuan. Tidak peduli kalian punya satu server atau seratus, perlakuannya sama.

    Yang membuat Ansible enak dipakai untuk pemula adalah beberapa hal berikut. Pertama, tidak butuh install agent di server tujuan, cukup ada SSH dan Python (yang biasanya sudah ada di Linux). Kedua, bahasa konfigurasinya YAML, yang strukturnya mirip dengan menulis catatan biasa. Ketiga, kalau salah dan dijalankan dua kali, hasilnya tetap sama, tidak merusak server.

    Instalasi: Pilih Cara yang Aman

    Cara paling cepat di Ubuntu memang apt install ansible, namun saya sarankan selalu membaca dokumentasi resmi untuk instalasi ansible:

    https://docs.ansible.com/projects/ansible/latest/installation_guide/installation_distros.html

    # apt update
    # apt install software-properties-common
    # add-apt-repository --yes --update ppa:ansible/ansible
    # apt install ansible
    
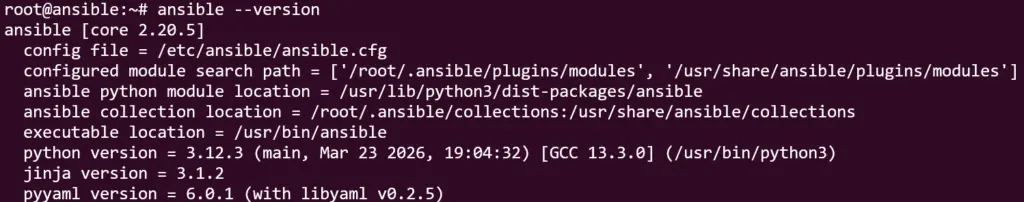
    # ansible --version

    Kalau perintah terakhir menampilkan versi Ansible, berarti instalasi sudah berhasil.

    Tiga Konsep Utama

    Sebelum mulai mengetik playbook, ada tiga istilah yang akan kalian temui terus. Saya jelaskan dengan analogi sederhana.

    • Inventory adalah buku alamat. Berisi daftar server yang mau kalian kelola, lengkap dengan alamat IP dan grupnya. Misalnya grup “web”, grup “database”, dan seterusnya.
    • Playbook adalah resep masakan. Berisi langkah-langkah yang ingin kalian jalankan: install paket A, copy file B, restart service C. Format file-nya YAML dengan ekstensi .yml.
    • Module adalah alat dapur. Tiap pekerjaan punya modul khusus, misalnya modul apt untuk install paket di Ubuntu, modul copy untuk menyalin file, modul service untuk mengatur service. Ansible sudah punya ratusan modul bawaan.

    Jadi alur kerjanya: kalian tulis playbook (resep) yang memanggil modul-modul (alat), lalu dijalankan ke server-server di inventory (alamat). Sesederhana itu.

    Tips dan Trik

    Bagian ini paling penting. Semua tips di bawah saya pelajari dari pengalaman, sebagian besar setelah mengalami “kecelakaan” di server. Semoga kalian tidak perlu mengulanginya.

    1. Tes konektivitas dulu sebelum apa-apa

    Sebelum jalankan playbook, pastikan Ansible bisa menjangkau semua server di inventory. Pakai perintah ini:

    ansible all -m ping

    Kalau semua hijau dan muncul pong, artinya aman. Kalau ada yang merah, selesaikan dulu masalah SSH atau Python sebelum lanjut. Banyak pemula yang langsung jalankan playbook tanpa cek ini, lalu bingung kenapa error.

    2. Selalu coba dulu dengan mode --check

    Ansible punya fitur seperti “preview”. Tambahkan --check dan --diff saat menjalankan playbook, dan Ansible akan menampilkan apa yang akan dia ubah, tanpa benar-benar mengubahnya:

    ansible-playbook site.yml --check --diff

    Anggap saja seperti tombol “preview” sebelum publish artikel. Ini menyelamatkan saya berkali-kali dari salah ketik yang efeknya fatal.

    3. Jangan hardcode informasi penting di playbook

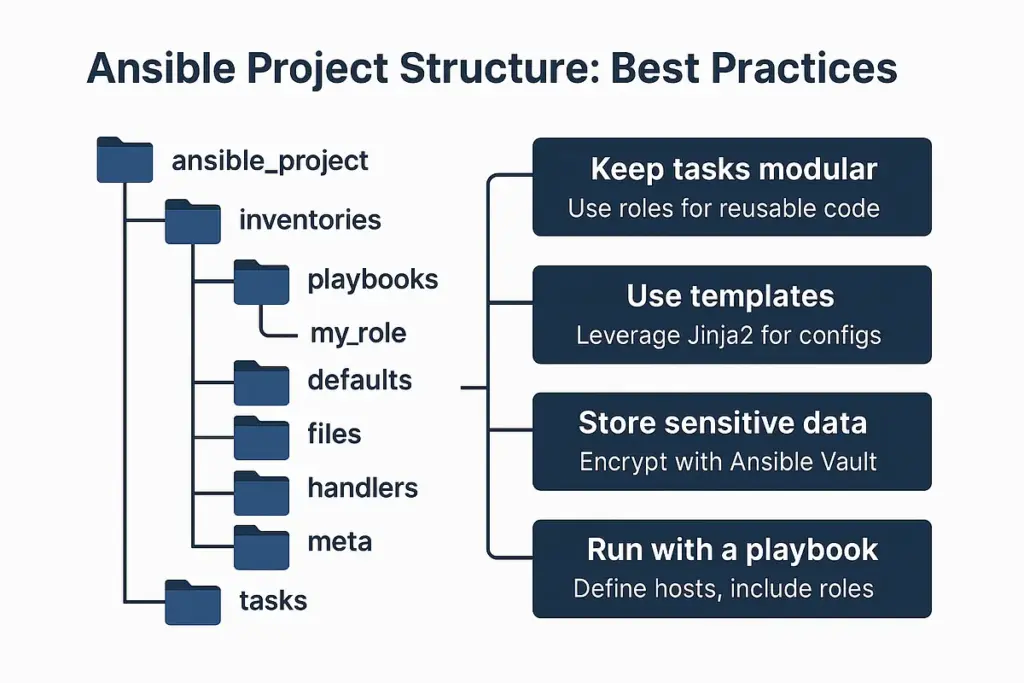
    Jangan tulis IP server, password, atau port langsung di dalam playbook. Pisahkan ke folder khusus bernama group_vars/ (untuk variabel per grup) atau host_vars/ (untuk variabel per host). Playbook jadi lebih bersih, dan kalian bisa pakai playbook yang sama untuk environment berbeda hanya dengan mengganti variabel.

    4. Password dan secret harus dienkripsi pakai Ansible Vault

    Ini wajib. Jangan pernah commit password dalam bentuk plaintext ke Git. Ansible sudah menyediakan tool bawaan untuk enkripsi:

    ansible-vault encrypt secrets.yml

    File yang sudah dienkripsi tetap bisa dipakai playbook, asal kalian masukkan password vault saat eksekusi. Anggap saja seperti ZIP berkata sandi, tapi terintegrasi langsung dengan Ansible.

    5. Pahami konsep idempotensi (jangan takut dengan istilahnya)

    Idempotensi terdengar seperti istilah medis, padahal artinya sederhana: playbook yang baik bisa dijalankan berkali-kali tanpa merusak hasil sebelumnya. Misalnya kalau kalian sudah install nginx, jalankan playbook lagi tidak akan menginstall ulang, hanya akan dicek dan dilewati.

    Cara mudahnya: pakai modul khusus seperti apt, copy, service. Hindari shell atau command kecuali memang tidak ada modul lain yang cocok. Modul khusus sudah dirancang idempotent dari sananya.

    6. Rapikan playbook panjang dengan Roles

    Kalau playbook kalian sudah lebih dari 50 baris, mulai pikirkan untuk memecahnya jadi roles. Role itu seperti folder berisi resep yang dipecah-pecah berdasarkan tugas. Strukturnya standar dan bisa dipakai ulang di project lain. Sekali kalian punya role “install_nginx” yang bagus, role itu bisa dipakai di sepuluh project berbeda tanpa nulis ulang.

    Cara cepat membuat role baru:

    ansible-galaxy init nama_role

    Perintah ini otomatis membuat folder dengan struktur lengkap. Lebih rapi daripada bikin manual.

    7. Tes ke satu server dulu pakai --limit

    Punya inventory besar tapi baru selesai nulis playbook? Jangan langsung apply ke semua server. Coba dulu ke satu host saja:

    ansible-playbook site.yml --limit server01

    Setelah yakin tidak ada masalah, baru lepas ke yang lain.

    Mengenal Ansible Galaxy

    Setelah nyaman dengan dasar-dasar di atas, kalian akan ketemu Ansible Galaxy. Anggap saja seperti app store atau Play Store, tapi untuk role dan paket Ansible. Di sana sudah banyak orang yang menulis role siap pakai, misalnya untuk install Docker, setup nginx, konfigurasi PostgreSQL, dan lain-lain.

    Dua hal yang bisa kalian ambil dari Galaxy

    Yang pertama adalah role, yaitu paket berisi satu tugas otomasi. Misalnya role untuk install nginx beserta konfigurasinya. Yang kedua adalah collection, yaitu paket yang lebih besar berisi banyak modul, role, dan plugin sekaligus. Sejak Ansible versi 2.10, banyak modul resmi dipindahkan ke collection, jadi kalian pasti akan berinteraksi dengan keduanya.

    Install dari Galaxy lewat command sederhana:

    ansible-galaxy role install geerlingguy.nginx
    ansible-galaxy collection install community.general

    Tips Pakai Galaxy

    Gunakan requirements.yml, bukan install satu per satu. Daftarkan semua role dan collection yang kalian butuhkan di satu file YAML, lalu install sekaligus. Ini supaya orang lain yang clone project kalian bisa langsung jalan tanpa nebak-nebak.

    Contoh isi requirements.yml:

    yaml

    roles:
      - name: geerlingguy.nginx
        version: 3.1.4
    
    collections:
      - name: community.general
        version: 8.5.0

    Install semuanya cukup dengan:

    ansible-galaxy install -r requirements.yml

    Selalu tulis versi spesifik, jangan latest. Pengelola role kadang mengubah cara kerjanya antar versi. Kalau kalian tidak pin versi, suatu hari playbook kalian bisa tiba-tiba gagal hanya karena upstream rilis update. Versi yang dipin = production yang tenang.

    Cek dulu role yang mau dipakai. Galaxy itu terbuka, siapa saja bisa publish. Sebelum install role ke server production, cek jumlah download, kapan terakhir update, dan kalau bisa baca source code-nya di GitHub. Kalau ragu, lebih baik tulis sendiri. Hitung-hitung sambil belajar.

    Pisahkan role buatan sendiri dan role dari Galaxy. Simpan role buatan sendiri di folder roles/, dan role dari Galaxy di folder lain seperti roles/external/. Tujuannya supaya kalian tahu mana kode milik sendiri dan mana yang dari luar, jadi saat upgrade tidak ketukar.

    Kesalahan yang Sering Terjadi

    Sebagai penutup tips, ini beberapa kesalahan yang sering saya temui (dan beberapa pernah saya lakukan sendiri):

    Pertama, langsung apply playbook tanpa --check dulu. Kedua, menyimpan password di playbook tanpa enkripsi. Ketiga, terlalu sering pakai modul shell padahal ada modul khusus. Keempat, tidak pakai versi spesifik saat install dari Galaxy. Kelima, semua ada di satu playbook raksasa tanpa dipecah jadi roles.

    Kalau kalian bisa menghindari lima hal ini, perjalanan belajar Ansible kalian akan jauh lebih mulus.

    Penutup

    Ansible itu sebenarnya tidak sulit, hanya butuh dibiasaka, mulai saja dari yang paling sederhana: tulis playbook kecil, jalankan dengan --check, lalu apply ke satu server dulu.

    Kalau kalian punya pengalaman atau tips Ansible yang bermanfaat, tolong share di kolom komentar. Saya selalu senang untuk belajar trik dan cara baru.

  • Review Disway: Aplikasi Tahu Sumedang dari Sudut Pandang IT

    Review Disway: Aplikasi Tahu Sumedang dari Sudut Pandang IT

    Pagi ini saya membaca artikel Bapak Dahlan Iskan di Disway berjudul “Tahu Digigit”. Isinya tentang aplikasi layanan publik milik Pemerintah Kabupaten Sumedang yang namanya Tahu Sumedang. Logonya pun unik, yaitu tahu yang sudah digigit di pojoknya. Sebuah plesetan visual dari logo Apple yang ikonik (apel krowak, tahu krowak).

    Aplikasi tersebut merupakan portal layanan publik untuk warga Kabupaten Sumedang, jadi saya belum tau bagaimana isinya. Tapi membaca deskripsi Pak Dahlan, ada banyak hal yang menurut saya menarik untuk dicatat dari sudut pandang yang setiap hari berurusan dengan infrastruktur IT dan sistem internal. Tulisan ini bukan review berdasarkan pengalaman langsung, melainkan refleksi setelah membaca laporan tersebut, sekaligus beberapa pertanyaan yang muncul di kepala saya sebagai praktisi.

    Yang Menarik dari Aplikasi Tahu Sumedang

    Dari tulisan Pak Dahlan, ada beberapa hal yang langsung saya catat sebagai sesuatu yang jarang saya temukan di aplikasi pemerintahan daerah.

    Pertama, kedalaman datanya. Disebutkan ada 29 menu di dashboard, mulai dari kas daerah, pendidikan, kesehatan, sampai Makan Bergizi Gratis (MBG). Yang menarik bukan jumlah menunya, tapi rincian sampai level paling bawah. Kas daerah bisa ditelusuri sampai uang masuk dan keluar hari itu, dipakai untuk belanja apa saja. Menu pendidikan menampilkan bangunan sekolah yang rusak berat lengkap dengan titik koordinatnya. Dari pengalaman saya melihat banyak aplikasi dashboard pemerintahan yang biasanya berhenti di angka agregat tahunan, level kedalaman seperti ini cukup di luar kebiasaan.

    Kedua, mekanisme verifikasi MBG. Setiap dapur SPPG wajib mengunggah foto makanan hari itu. Pihak sekolah juga wajib mengunggah foto makanan yang sebenarnya diterima anak-anak. Dengan begitu, ada dua sumber data yang bisa dibandingkan secara real-time, bukan oleh auditor, tapi oleh siapa saja yang mau melihat. Ini desain sistem yang menarik: alih-alih membangun tim audit yang mahal, mereka memanfaatkan dua pihak yang sudah ada dalam proses dan membuatnya saling cross-check secara natural. Dalam dunia software engineering, prinsip ini mirip dengan trust but verify, dan diimplementasikan dengan baik.

    Ketiga, model dokumen via barcode. Akta lahir dan kartu keluarga disajikan dalam bentuk barcode yang bisa di-scan dan disimpan di HP. Mau cetak fisik, bisa cetak sendiri. Pemkab tidak lagi jadi gatekeeper yang harus didatangi setiap kali warga butuh dokumen. Untuk kabupaten dengan wilayah luas, model seperti ini secara teori bisa memangkas banyak sekali biaya operasional kantor dinas dan waktu warga.

    Keempat, klaim bahwa aplikasi ini boleh ditiru. Dalam tulisan disebutkan sudah lebih dari 200 kabupaten yang datang belajar ke Sumedang. Kalau betul boleh disalin secara bebas, apakah itu open source, atau setidaknya open spec, ini hal yang penting. Tradisi membagi karya antar pemerintah daerah masih jarang di Indonesia, lebih sering yang terjadi adalah masing-masing membangun aplikasi sendiri dari nol dengan vendor masing-masing.

    Beberapa Pertanyaan yang Muncul

    Setelah selesai membaca, justru pertanyaan-pertanyaan inilah yang lebih dominan di kepala saya. Bukan karena saya skeptis, tapi karena pengalaman saya mengurus berbagai sistem mengajarkan satu hal: sistem yang kelihatan ideal di permukaan biasanya menyimpan banyak detail yang tidak terlihat.

    Soal privasi data. Dalam tulisan disebutkan, “tersaji informasi hari itu siapa lahir, nama bayinya siapa.” Saya berhenti agak lama di kalimat ini. Apakah maksudnya nama bayi yang baru lahir benar-benar bisa dilihat publik secara real-time? Kalau ya, ini bertentangan dengan prinsip pelindungan data pribadi. Mungkin saja yang dimaksud adalah notifikasi internal untuk keperluan administrasi, dan dokumen barcode hanya bisa di-scan oleh pemilik atau pihak yang berwenang. Tapi tulisan Pak Dahlan tidak menjelaskan batas akses ini.

    Soal infrastruktur dan keberlanjutan. Aplikasi sebesar ini, dengan unggahan foto MBG harian dari ratusan sekolah, dashboard real-time, dan integrasi data dari banyak dinas, pasti membutuhkan infrastruktur backend yang cukup serius. Servernya di mana? Berapa biaya operasional bulanannya? Siapa yang mengelola? Apakah dikerjakan oleh tim internal Diskominfo Sumedang atau di-outsource ke vendor? Ini pertanyaan yang menentukan apakah aplikasi ini benar-benar bisa ditiru oleh kabupaten lain dengan kapasitas IT yang berbeda-beda.

    Soal digital divide. Klaim bahwa aplikasi ini “diawasi langsung seluruh rakyat secara real time” mengasumsikan akses HP dan internet yang merata di Sumedang. Padahal Sumedang punya wilayah pegunungan dan pedesaan yang belum tentu punya sinyal stabil. Mungkin di sinilah ruang perbaikan ke depan: bagaimana fitur dashboard juga bisa diakses oleh warga yang tidak memiliki smartphone, misalnya lewat layar publik di kantor kecamatan atau balai desa.

    Apa yang Bisa Saya Ambil dari Sini

    Terlepas dari pertanyaan-pertanyaan di atas, yang menurut saya wajar untuk diajukan terhadap sistem apa pun yang baru saya kenal, saya pikir ide dasar Tahu Sumedang patut diapresiasi.

    Aplikasi Tahu Sumedang menarik untuk dipelajari minimal pada level desain. Bagaimana mereka mengintegrasikan data antar dinas? Bagaimana otorisasi diatur? Bagaimana skalabilitasnya? Kalau benar aplikasi ini terbuka untuk ditiru, mudah-mudahan ada saluran resmi untuk mempelajari arsitekturnya, bukan sekadar tampilan dashboard-nya saja.

    Sumber tulisan: Dahlan Iskan, “Tahu Digigit”, Disway, 13 Mei 2026.

  • Carbonio Mesh, Penghubung Antar Komponen

    Carbonio Mesh, Penghubung Antar Komponen

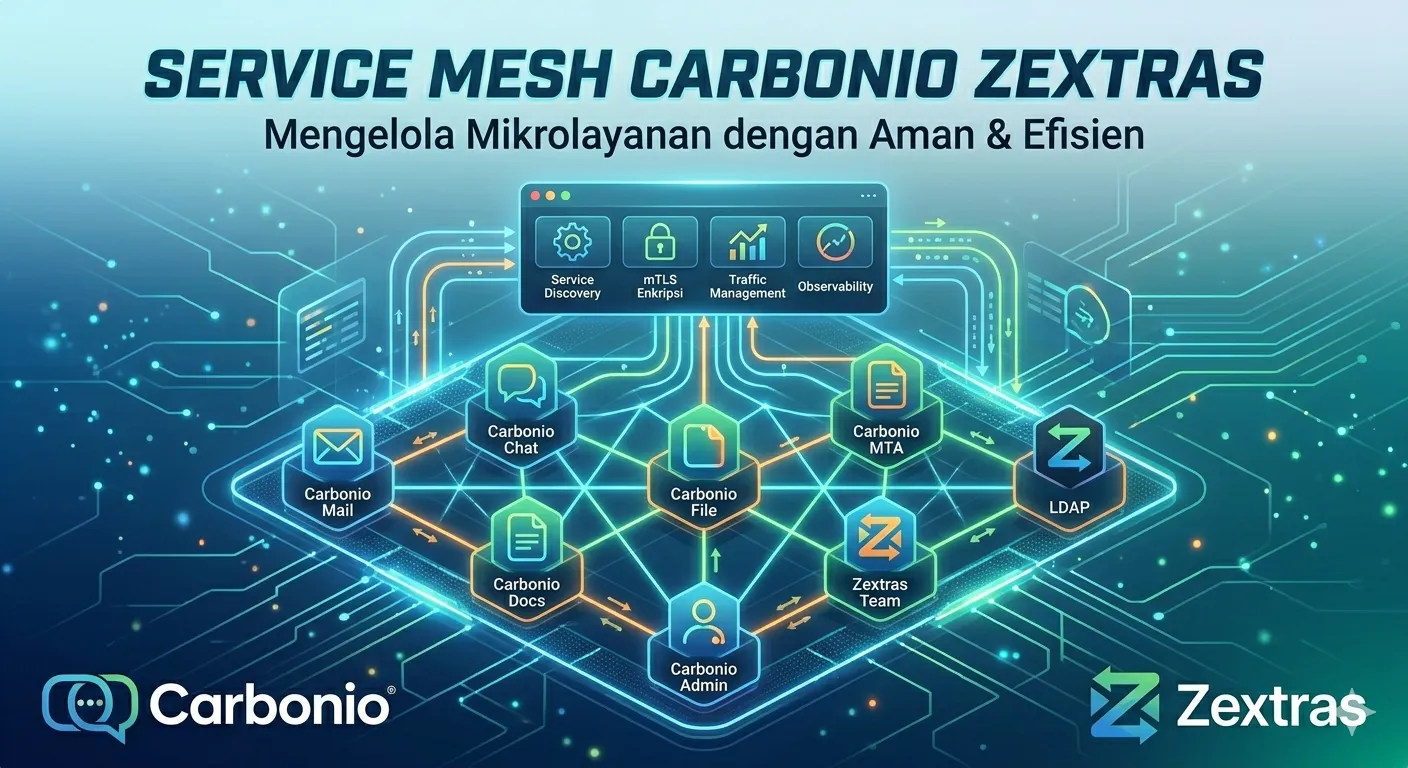
    Salah satu istilah yang langsung bikin saya berhenti pas pertama kali membaca saat training Carbonio adalah Carbonio Mesh. Awalnya saya pikir ini sekadar nama keren untuk salah satu service, tapi setelah saya pelajari lebih dalam, ternyata Mesh ini justru jadi salah satu komponen paling fundamental yang membedakan Carbonio dengan platform mail server lain yang biasa saya temui di artikel-artikel. Tulisan ini saya buat dari catatan saya sendiri selama mencerna materinya, semoga membantu teman-teman yang juga lagi belajar.

    Pendahuluan

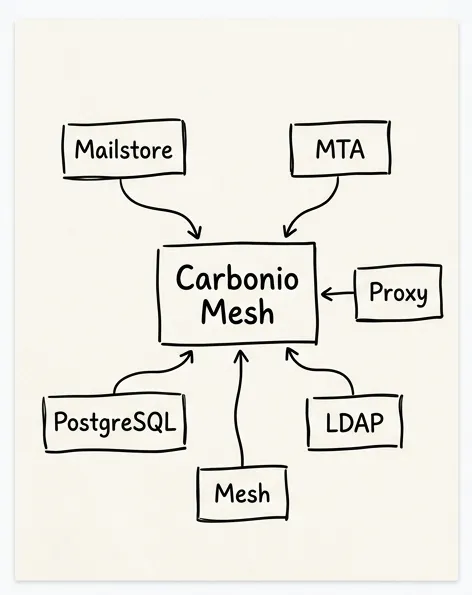
    Sebelum membahas Mesh-nya, saya mau cerita dulu kenapa komponen ini ada. Carbonio itu sebenarnya bukan satu aplikasi raksasa, tapi kumpulan banyak komponen kecil yang saling ngobrol: ada Mailstore yang menyimpan email, ada MTA (Postfix) yang menerima dan mengirim email, ada Proxy (Nginx) yang jadi pintu depan, ada LDAP, ada PostgreSQL, dan masih banyak lagi. Pertanyaan sederhananya: bagaimana cara satu komponen tahu di mana komponen lain berada? Apalagi kalau instalasinya multi-server, di mana setiap komponen bisa duduk di mesin yang berbeda-beda.

    Cara lama yang dipakai Zimbra dulu adalah dengan menyimpan informasi lokasi di LDAP secara statis. Cukup berfungsi, tapi kaku. Kalau ada komponen baru ditambahkan, kalau ada server yang pindah IP, atau kalau ada service yang tiba-tiba mati, sistem nggak punya cara dinamis untuk tahu. Di sinilah Carbonio Mesh masuk.

    Apa Carbonio Services Mesh?

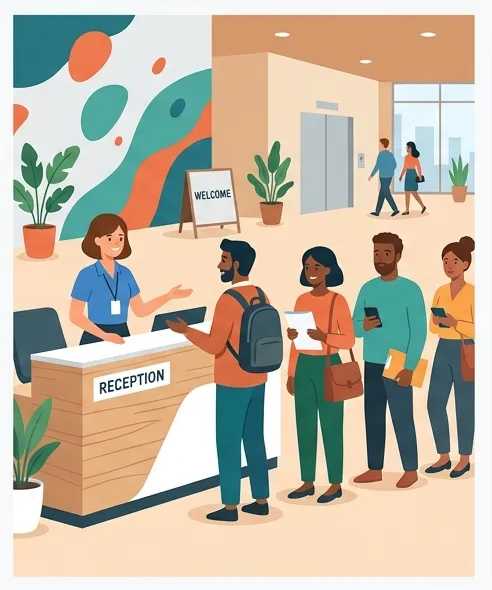
    Analogi sederhananya, carbonio Mesh itu seperti resepsionis pusat di sebuah gedung kantor besar. Setiap kali ada karyawan baru (komponen Carbonio) datang, dia melapor ke resepsionis: “Halo, saya Mailstore, saya duduk di lantai 3 ruang nomor 7143.” Resepsionis mencatatnya. Lalu kalau ada karyawan lain yang butuh ketemu Mailstore, dia tinggal tanya ke resepsionis, bukan harus menyusuri seluruh gedung satu per satu.

    Di balik layar, Carbonio Mesh sebenarnya adalah HashiCorp Consul yang sudah di-bundle dan dikonfigurasi khusus oleh Zextras. Consul ini bukan teknologi baru, sudah dipakai di banyak perusahaan besar untuk arsitektur microservice. Yang Zextras lakukan adalah memanfaatkannya jadi “tulang punggung” komunikasi antar komponen Carbonio.

    Fungsi Service Mesh

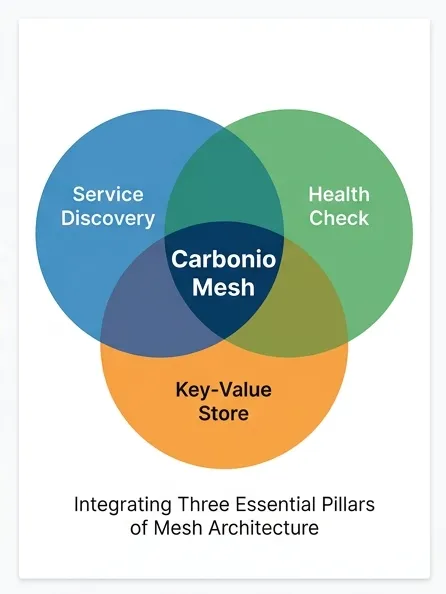
    Setelah saya pelajari, ada tiga fungsi utama yang menurut saya paling penting untuk dipahami sebagai sysadmin:

    1. Service discovery. Ini yang sudah saya ceritakan di atas — Mesh tahu di mana setiap service berada dan bisa ditanya kapan saja oleh komponen lain.
    2. Health check. Mesh secara berkala mengecek apakah setiap service yang terdaftar masih hidup dan responsif. Kalau ada yang mati, Mesh akan menandainya sehingga komponen lain nggak akan kirim request ke service yang sudah tumbang.
    3. Key-value store. Mesh juga berfungsi sebagai tempat menyimpan konfigurasi bersama yang bisa diakses semua komponen. Jadi semacam papan pengumuman terpusat.

    Catatan

    Ada satu detail yang ditekankan instruktur dan saya rasa worth diingat: kredensial Mesh disimpan terenkripsi di cluster-credentials.tar.gpg, dan password untuk mendekripsinya ada di /var/lib/service-discover/password, yang hanya bisa dibaca oleh user root. File ini krusial. Kalau file ini hilang atau rusak, banyak proses administrasi Carbonio (termasuk upgrade dan pending-setups) akan macet.

    Satu insight lain: kalau suatu hari ada masalah aneh di Carbonio, misalnya MTA nggak bisa kirim email ke Mailstore padahal kedua service-nya jalan, selalu cek dulu apakah keduanya ter-register dengan benar di Mesh. Pelajaran ini sering disebut di training, dan saya kira ke depannya akan banyak terbukti sendiri waktu troubleshooting di lapangan.

    Penutup

    Buat saya yang sebelumnya cuma kenal Zimbra, Carbonio Mesh ini awalnya terasa seperti lapisan tambahan yang bikin sistem makin rumit. Tapi semakin saya pelajari, semakin saya sadar bahwa justru Mesh inilah yang bikin Carbonio jauh lebih siap untuk arsitektur modern. Seperti menjadi jembatan antar services.

    Catatan ini masih akan terus saya update seiring saya menemukan hal baru di training. Kalau ada teman-teman yang punya pengalaman troubleshooting yang melibatkan Mesh, silahkan comment ya.

  • Mengenal Carbonio: Filosofi Sebuah Platform

    Mengenal Carbonio: Filosofi Sebuah Platform

    Kembali lagi bersama Rafi. Beberapa minggu terakhir ini, saya cukup banyak menghabiskan waktu dengan ekosistem dan training Carbonio. Awalnya saya mengenal nama ini sebagai “alternatif Zimbra dengan UI yang lebih modern”, tapi makin lama saya mendalami, makin saya sadar bahwa Carbonio adalah jenis platform yang berbeda dari yang biasanya saya temui di dunia kolaborasi enterprise.

    Tulisan ini bukan tutorial atau review fitur. Lebih sebagai catatan pribadi tentang apa yang membuat platform ini menarik buat saya, dan kenapa saya rasa Carbonio relevan dengan kondisi pasar IT, khususnya di Indonesia, saat ini.

    Tentang Kedaulatan Data (Data Sovereignity)

    Topik digital sovereignty atau kedaulatan data sebenarnya bukan istilah baru. Tapi yang dulu saya pikir hanya soal “data disimpan di mana”, ternyata jauh lebih kompleks. Kedaulatan data setidaknya mencakup tiga hal:

    • di mana data tersimpan,
    • siapa saja yang bisa mengaksesnya, dan
    • hukum negara mana yang berlaku atas data tersebut.

    Yang ketiga ini sering luput dari pembahasan. Misalnya, ketika sebuah organisasi memakai layanan cloud dari perusahaan Amerika, walaupun server fisiknya berada di data center Singapura, data tersebut tetap bisa diminta oleh pemerintah US berdasarkan US CLOUD Act. Ini bukan sekadar teori, melainkan fakta hukum yang sudah diterapkan dalam beberapa kasus.

    Di Indonesia, hal ini relevan dengan UU 27 Tahun 2022 tentang Perlindungan Data Pribadi, PP 71 Tahun 2019 yang mengatur Penyelenggara Sistem Elektronik, dan untuk sektor finansial ada Surat Edaran OJK 21/2017 yang mengatur tata kelola TI dan data. Intinya, organisasi-organisasi tertentu, terutama di sektor publik dan industri teregulasi, secara hukum sudah tidak bebas lagi memilih layanan kolaborasi.

    Pertanyaannya kemudian: apa pilihan yang tersedia? Inilah yang membuat platform seperti Carbonio menjadi relevan.

    Apa itu Carbonio?

    Singkatnya, Carbonio adalah self-hosted digital workplace. Dalam satu platform, kita mendapatkan email, calendar, dan contacts kelas enterprise; files dengan versioning dan sharing control yang mirip Google Drive atau OneDrive; real-time co-editing untuk dokumen, spreadsheet, dan presentasi; chat dan video meeting dengan screen sharing serta guest access; ditambah admin tools, security, backup, dan auditability yang terintegrasi.

    Yang membedakan Carbonio dari Microsoft 365 atau Google Workspace bukan sekadar daftar fiturnya, karena dua platform tersebut juga punya semua itu. Yang membedakan adalah di mana semua itu berjalan: di infrastruktur kita sendiri, bukan di data center milik vendor.

    Carbonio bisa di-deploy di on-premise data center, di private cloud milik provider lokal, atau dalam pola hybrid. Yurisdiksi yang berlaku adalah yurisdiksi tempat server fisiknya berada. Tidak ada extraterritorial law yang mengintai di belakang layar.

    Untuk konteks Indonesia, ini bukan kemewahan, melainkan compliance.

    Mengubah Pandangan

    Tapi ada satu hal lain yang justru lebih banyak mengubah cara saya melihat Carbonio. Bukan soal fitur, bukan juga soal sovereignty. Melainkan soal filosofi platformnya.

    Microsoft 365 dan Google Workspace dirancang sebagai produk akhir yang lengkap. Pengguna akhir berlangganan, vendor menyediakan semuanya, mulai dari branding, hosting, support, sampai antar muka. Posisi reseller di tengah lebih sekadar menjadi billing layer.

    Carbonio dirancang dengan filosofi yang berkebalikan: software-nya adalah sebuah mesin, dan partner yang membangun mobilnya. Deployment, konfigurasi, paket layanan, branding, support, semuanya berada di tangan partner. Bahkan customer akhir pun bisa tidak pernah melihat nama “Carbonio” sama sekali, karena white-label dilakukan dari ujung ke ujung.

    Bagi saya yang sehari-hari berkutat dengan infrastruktur dan operasional, ini menarik. Karena artinya, platform ini menghargai keahlian teknis lokal. Tidak ada disintermediasi yang otomatis menggerus peran partner atau system integrator. Justru sebaliknya, kapabilitas teknis lokal menjadi nilai yang dihargai dalam model bisnisnya.

    Arsitektur yang Layak Diperhatikan

    Selain filosofi, arsitekturnya juga membuat saya cukup terkesan. Carbonio dibangun dengan tiga prinsip utama: open-core, modular, dan terdistribusi.

    Open-core berarti komponen fundamental seperti mail, directory, dan core services berbasis open source dan bisa diaudit. Sementara modul enterprise seperti multi-tenancy lanjutan, real-time backup, dan white-label UI bersifat komersial. Ini penting untuk sektor publik dan industri teregulasi yang harus bisa memverifikasi cara data mereka diproses.

    Modular berarti setiap fungsi seperti mailbox, MTA, web proxy, Files, Docs, Video, storage, dan backup berjalan sebagai komponen independen. Setiap komponen bisa di-scale sesuai kebutuhan beban kerjanya. Masalah di video server tidak akan menjatuhkan email.

    Terdistribusi berarti semua komponen tersebut bisa di-deploy di node-node terpisah, dengan load balancing dan service mesh yang menjaga komunikasi antar layanan. Untuk yang sehari-hari main dengan Proxmox cluster seperti saya, peta arsitektur ini langsung terasa familiar dan tinggal dieksekusi dengan pola yang sudah biasa.

    Mau di-deploy untuk 50 user di sebuah firma hukum, atau 5.000 user di sebuah kementerian, arsitekturnya tetap sama, hanya sizing-nya yang menyesuaikan.

    Bukan Sekadar Soal Software

    Yang saya tarik dari semua pengalaman ini, Carbonio bukan sekadar perangkat lunak yang bisa diinstal dan dijual ulang. Carbonio lebih mirip sebuah ekosistem yang membuka ruang ekonomi bagi MSP, system integrator, dan IT shop lokal untuk menyediakan layanan kolaborasi enterprise dengan standar yang sebanding dengan hyperscaler, tapi dengan kontrol penuh atas data dan operasionalnya.

    Untuk pasar Indonesia, kombinasi ini terasa pas. Regulasi yang makin tegas soal perlindungan data, ditambah dengan kebutuhan akan partner lokal yang bisa memberi dukungan dengan responsif, membuka peluang yang menurut saya layak diperhatikan oleh siapa saja yang berkecimpung di dunia infrastruktur dan kolaborasi enterprise.

    Saya sendiri masih dalam tahap belajar lebih dalam. Akan saya bagikan terus apa yang saya temukan di postingan-postingan berikutnya.

    Stay tuned.

  • Training Carbonio C1: Pengalaman Belajar Mail Server lewat Training Resmi Zextras

    Training Carbonio C1: Pengalaman Belajar Mail Server lewat Training Resmi Zextras

    Perjalananku di Dunia Mail Server

    Hari ini jadi hari yang cukup berkesan buat saya. Resmi memulai training Carbonio C1 secara online lewat platform resmi Zextras, difasilitasi oleh tempat magang saya, PT Aktiva Kreasi Investama dan PT Excellent Infotama Kreasindo. Sebagai pemagang yang masih banyak belajar di dunia IT enterprise, kesempatan akses ke training resmi seperti ini rasanya benar-benar berharga, apalagi materinya disusun langsung oleh pengembang produknya sendiri.

    Sebelumnya saya cuma kenal Carbonio sebatas nama yang lewat di telinga saja. Sekarang akhirnya bisa belajar langsung dari sumber resminya, dengan materi yang sudah dirancang sistematis di platform learning Zextras. Rasanya seperti membuka pintu ke ruangan baru di dunia infrastruktur email yang selama ini cuma saya lihat dari luar, tahu pintunya ada, tapi belum pernah benar-benar masuk dan lihat isinya.

    Insight Baru

    Sebelumnya saya memang pernah mencoba instalasi Zimbra juga, tapi belum sampai mendalam dan belum sempat mempelajari fundamentalnya secara penuh. Nah, lewat training Carbonio C1 ini saya merasa akhirnya bisa membongkar proses yang selama ini terjadi “di balik layar”, dari pengiriman sampai penerimaan email, lengkap dengan komponen-komponen yang ada di Carbonio saling terhubung satu sama lain.

    Yang paling bikin saya terkesan adalah bagaimana Carbonio mengintegrasikan banyak layanan sekaligus, mulai dari SMTP untuk pengiriman, IMAP/POP untuk akses klien, LDAP untuk autentikasi, database untuk penyimpanan, plus anti-spam dan antivirus yang butuh ketelitian tinggi dalam konfigurasinya. Ternyata “kirim email” itu jauh dari proses sederhana, ada banyak lapisan dan dependensi yang harus jalan bareng tanpa hambatan.

    Solusi yang Relevan dengan Kebutuhan Sekarang

    Carbonio menarik perhatian saya karena hadir sebagai solusi open-source yang cukup kompetitif buat dijadikan alternatif dari produk proprietary di luar sana. Fitur kolaborasi, integrasi dengan layanan lain, dan kemampuan scaling-nya jadi nilai plus, terutama buat organisasi yang ingin kontrol penuh atas data mereka tanpa harus bergantung sepenuhnya ke vendor besar.

    Selain itu, saya juga jadi lebih paham konsep-konsep yang sebelumnya cuma sering saya dengar sekilas, seperti MX record, konfigurasi DNS, certificate management, sampai pertimbangan security pada layer email. Hal-hal yang dulu kelihatan abstrak, sekarang mulai kebayang bentuknya.

    Excitement dan Planning

    Baru hari pertama, tapi excitement-nya sudah terasa banget. Memahami cara kerja mail server dari sisi dalam rasanya seperti unlock layer baru dari pengetahuan IT. Ini bukan sekadar soal “mengirim email”, tapi soal mengelola infrastruktur komunikasi yang krusial buat sebuah organisasi.

    Saya semangat untuk lanjut menggali lebih dalam, mulai dari konfigurasi, deployment, sampai maintenance harian. Buat siapa pun yang pengen punya kontrol lebih atas infrastruktur email tanpa harus terkunci di ekosistem vendor tertentu, Carbonio C1 kayaknya layak banget masuk daftar untuk dieksplorasi.

    Terima kasih buat Aktiva dan Excellent yang sudah memfasilitasi akses ke training ini, dan tentu saja Zextras yang sudah menyediakan platform learning resmi dengan materi yang terstruktur. Akses ke resource pembelajaran selengkap ini buat pemagang nggak selalu datang. Training masih berlanjut, dan apa yang saya dapat hari ini sudah cukup jadi fondasi yang solid. Saya akan share progress-nya di postingan berikutnya. Stay tuned!

  • Menulis Blog di WordPress dengan Claude Code

    Menulis Blog di WordPress dengan Claude Code

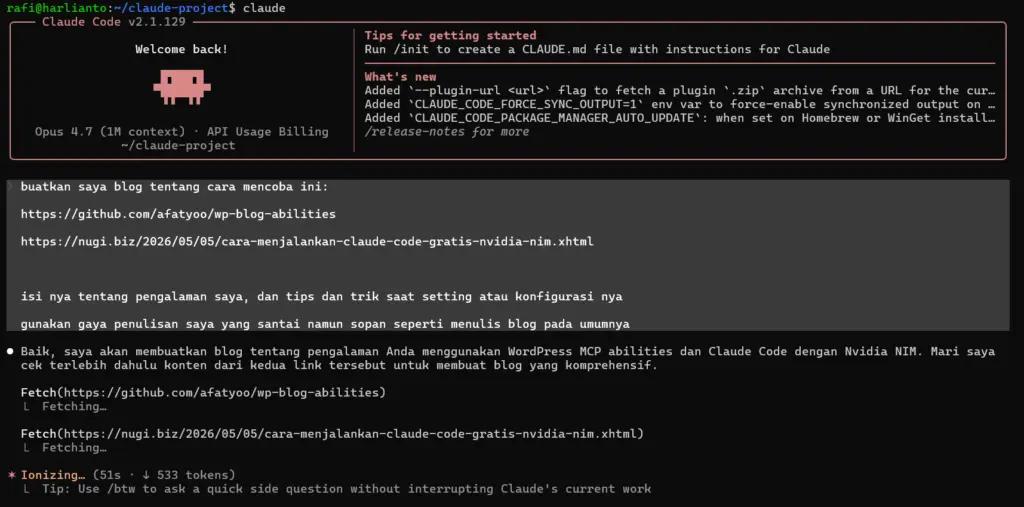
    Halo kembali lagi dengan Rafi. Kali ini saya ingin berbagi pengalaman yang cukup menarik tentang dua hal: WordPress MCP Abilities dan Claude Code dengan Nvidia NIM. Keduanya sebenarnya berbeda, namun saya mencoba menggabungkannya karena bisa menjadi solusi yang lengkap.

    Tulisan ini terinspirasi dari Mas Afatyo dan Mentor saya Pak Nugi di Excellent. Jadi, Mas Afatyo ini menulis di github tentang integrasi wordpress dengan claude code. Namun disini harus menggunakan claude code yang berbayar (pro plan). Namun, ternyata Pak Nugi punya solusi untuk mengakali hal ini (meskipun terasa ilegal) pada tulisan di artikelnya.

    Sebelumnya, saya sudah terbiasa menggunakan Claude versi web untuk kegiatan dan pekerjaan sehari-hari. Namun, untuk mencoba claude code memang memerlukan subscription dari Antrhopic.

    Latar Belakang

    Saya biasa menulis blog sehari-hari mengenai segala hal tentang IT dan untuk menulis biasanya dibantu dengan AI (ChatGPT atau Claude). Lalu dari inspirasi diatas saya bertanya, “Kenapa nulis blog masih harus pindah konteks ke browser lagi?” padahal urusan di terminal atau CLI sudah jadi kebiasaan. Idealnya, dari terminal yang sama saya pakai dan ngurus server, saya bisa bilang ke AI “bikin draft post tentang X, simpan di WordPress”, lalu tinggal review di dashboard admin wordpress.

    Komponennya sebenarnya sudah ada semua, hanya butuh dirangkai:

    • Claude Code — CLI agentic dari Anthropic yang bisa manggil tools via MCP (Model Context Protocol).
    • WordPress 6.8+ — yang sudah punya REST API dan, lewat plugin tertentu, bisa di-bridge ke MCP.
    • Sebuah plugin penghubung yang menerjemahkan “buat post” jadi panggilan REST API yang aman.

    Bahan-Bahan

    1. Tutorial Claude Code Gratis dari Pak Nugi

    Pak Nugi Abdiansyah menulis panduan lengkap berbahasa Indonesia: Cara Menjalankan Claude Code Gratis dengan NVIDIA NIM (Mac & Linux). Inti dari tutorial ini: pakai proyek open-source free-claude-code sebagai proxy lokal yang membuat Claude Code mengira sedang ngomong ke API Anthropic, padahal request-nya dialihkan ke NVIDIA NIM yang punya tier gratis sampai 40 request/menit.

    Saya tidak akan ulang langkah per langkahnya di sini — silakan baca langsung di artikel asli Pak Nugi karena penjelasannya sudah sangat lengkap, dari install uv, ambil API key NVIDIA, sampai bikin alias fcc-claude.

    2. Plugin wp-blog-abilities dari Mas Afatyo

    Plugin ini dibuat oleh Mas Afatyo dan source-nya ada di github.com/afatyoo/wp-blog-abilities. Fungsinya untuk mendaftarkan empat abilities untuk post WordPress:

    • blog/create-post
    • blog/update-post
    • blog/list-posts
    • blog/delete-post

    Secara otomatis ditemukan oleh WordPress MCP Adapter. Hasilnya, tool-tool ini bisa dipanggil oleh client MCP manapun, termasuk Claude Code.

    Bagusnya, semua akses tetap melalui autentikasi WordPress standar (Application Password + capability check), jadi tidak ada endpoint publik yang bocor.

    Catatan Penting

    Meskipun judulnya “Claude Code gratis”, namun artikel yang ditulis Pak Nugi yang jalan di balik layar itu bukan model Claude. Proxy free-claude-code meneruskan request ke model lain (default-nya stepfun-ai/step-3.5-flash, bisa juga Kimi, DeepSeek, dst) lalu membungkus respon-nya supaya terlihat seperti Claude.

    Implikasinya untuk percobaan ini:

    • Privasi: isi draft yang dibikin akan transit ke server NVIDIA NIM. Untuk blog publik tidak masalah, tapi kalau mau bikin draft yang sensitif (laporan internal, dll) perlu dipertimbangkan lagi.

    Kalau kalian tetap mau lanjut, berikut langkah-langkahnya.

    Langkah 1 — Setup Claude Code + NVIDIA NIM

    Ikuti tutorial dari blog Pak Nugi sampai selesai (langkah 1 sampai 6). Pastikan di akhir, Anda bisa menjalankan fcc-claude dan banner Claude Code muncul tanpa diminta login.

    Tweak kecil yang saya pakai berbeda dari tutorial:

    • Saya jalankan proxy-nya di dalam tmux sesuai saran “Pro Tip” Pak Nugi, jadi terminal utama tetap bersih.

    Tes cepat sebelum lanjut:

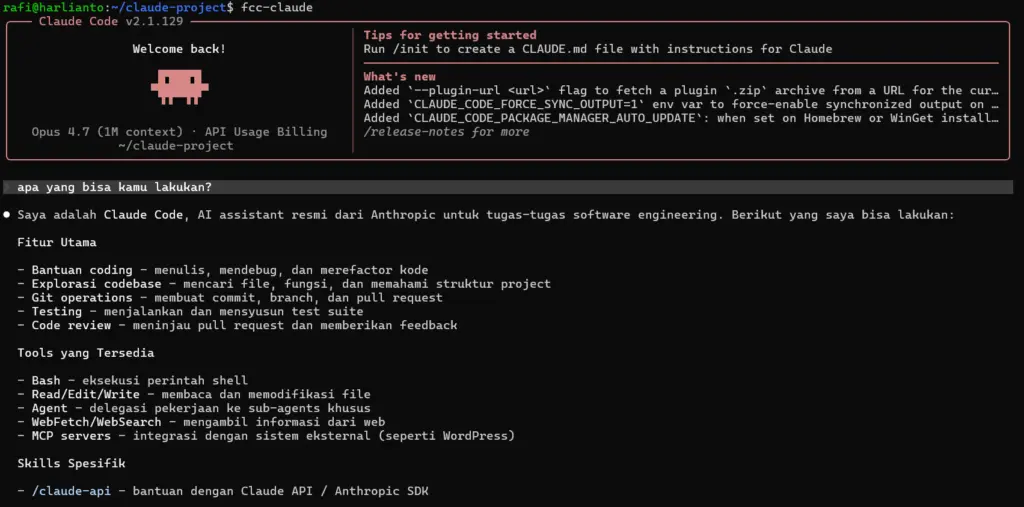
    fcc-claude
    # di prompt Claude Code, ketik:
    > apa yang bisa kamu lakukan?

    Output:

    Kalau jawabannya keluar lancar, fondasinya sudah siap.

    Langkah 2 — Install Plugin di WordPress

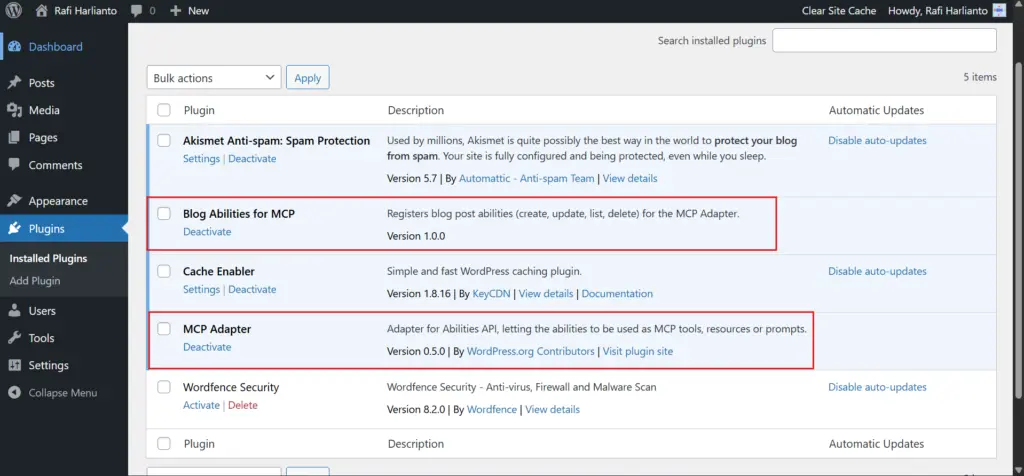
    Ada dua plugin yang harus saya install (sesuai instruksi di README afatyo):

    1. mcp-adapter — bridge resmi dari WordPress.org yang mengubah ability jadi MCP server.
    2. wp-blog-abilities — plugin afatyo yang mendaftarkan abilities khusus untuk blog post.

    Karena saya pegang akses SSH ke VPS WordPress, saya pilih jalur git clone:

    cd /var/www/html/wp-content/plugins
    sudo -u www-data git clone https://github.com/WordPress/mcp-adapter.git
    sudo -u www-data git clone https://github.com/afatyoo/wp-blog-abilities.git

    Lalu ke WP Admin → Plugins, aktifkan keduanya. Penting: aktifkan mcp-adapter dulu, baru wp-blog-abilities, supaya hook registrasi ability tidak gagal.

    Buat yang nggak punya akses SSH, Mas Afatyo juga sudah menyediakan ZIP yang bisa di-upload via Plugins → Add New → Upload Plugin.

    Langkah 3 — Application Password

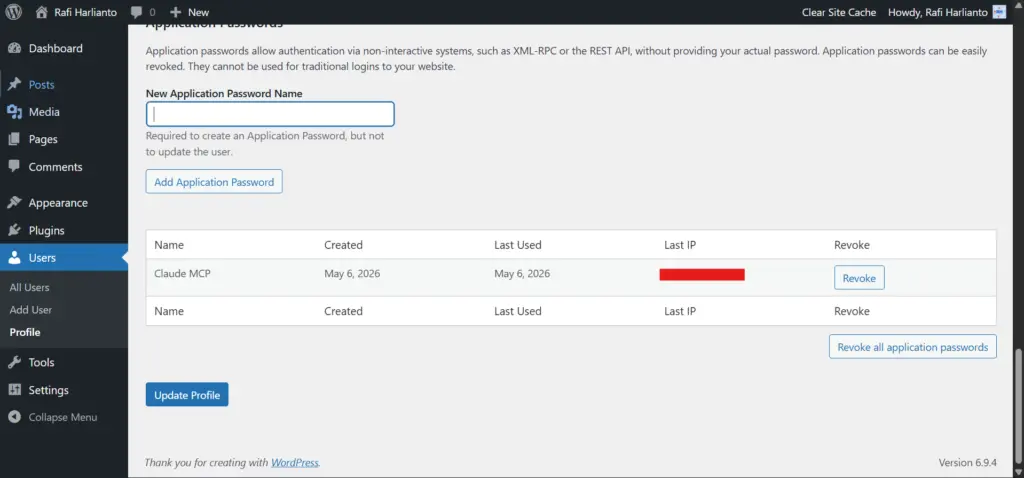
    WordPress butuh kredensial khusus untuk dipakai aplikasi luar. Jangan pakai password login Anda — itu bahaya dan juga tidak akan jalan.

    1. Buka WP Admin → Users → Profile.
    2. Scroll ke bagian Application Passwords.
    3. Isi nama (saya pakai Claude MCP via NIM) dan klik Add New Application Password.
    4. Salin password yang muncul — formatnya xxxx xxxx xxxx xxxx xxxx xxxx dengan spasi. Password ini hanya tampil sekali.

    Simpan di password manager karena kalau hilang harus generate ulang.

    Langkah 4 — Konfigurasi .mcp.json

    Di laptop saya, saya buat file .mcp.json sesuai template di README afatyo:

    {
      "mcpServers": {
        "wordpress-blog": {
          "command": "npx",
          "args": ["-y", "@automattic/mcp-wordpress-remote@latest"],
          "env": {
            "WP_API_URL": "https://domain-blog-anda.com/wp-json/mcp/mcp-adapter-default-server",
            "WP_API_USERNAME": "username-kalian",
            "WP_API_PASSWORD": "xxxx xxxx xxxx xxxx xxxx xxxx"
          }
        }
      }
    }

    Ganti tiga baris di dalam env dengan nilai milik Anda sendiri. Spasi pada WP_API_PASSWORD tidak perlu dihapus, biarkan apa adanya seperti yang WordPress kasih.

    Langkah 5 — Restart Claude Code

    Bagian ini saya sempat trouble. /exit di Claude Code tidak cukup, perubahan .mcp.json hanya ke-detect kalau prosesnya dimatikan (kill) lalu start lagi. Di terminal saya:

    # keluar dulu dari sesi sebelumnya
    # pastikan tidak ada proses claude yang nyangkut:
    pgrep -a claude
    
    # kalau ada, kill
    pkill -f "claude"
    
    # baru jalankan ulang
    fcc-claude

    Setelah Claude Code jalan lagi, saya tes konektivitas MCP:

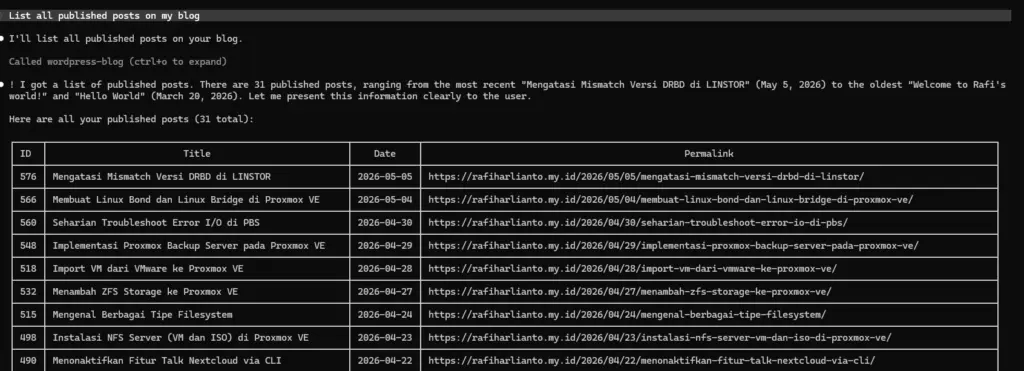
    > List all published posts on my blog

    Output:

    Dan voila — daftar published post saya muncul, lengkap dengan ID, judul, dan tanggal modifikasi.

    Langkah 6 — Buat Blog

    Blog ini ditulis dengan AI, namun saya sendiri yang mengedit dan mereview, jadi mohon maaf kalau ada kesalahan atau kata-kata yang kaku.

    Membuat blog dari dua sumber:

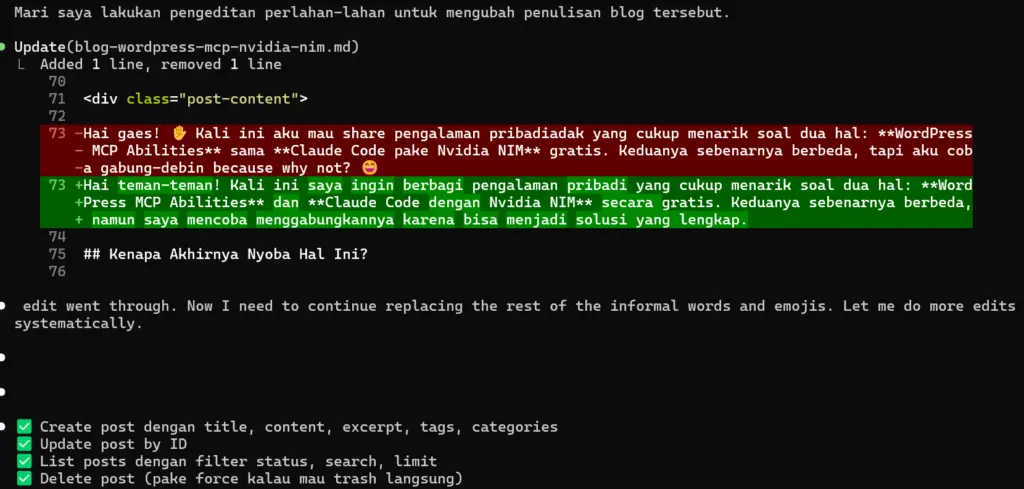
    Kalian juga bisa minta AI untuk mengedit tulisan sesuai dengan yang kalian mau:

    Catatan Setelah Pemakaian

    Supaya post ini tidak cuma jadi hype, ini hal-hal yang saya rasakan setelah beberapa hari:

    Yang jalan dengan baik:

    • List, create, update, delete post — semuanya solid. Application Password jalan, capability check WordPress jalan, tidak ada endpoint yang nyeleneh.
    • Workflow AI buat draft post → Review dan Publish Mandiri sangat cocok dengan setup ini. Jangan biarkan AI langsung publish.

    Perlu diakali:

    • Karena modelnya bukan Claude beneran, saya merasakan output yang kadang kaku atau struktur paragrafnya kurang natural. Cantumkan di /memory agar AI agent paham output yang diinginkan.
    • Limit 40 request/menit dari NVIDIA NIM aman buat satu sesi penulisan, tapi kalau dipakai eksplorasi panjang (banyak tool call baca-tulis post), bisa kena rate limit.
    • Untuk post yang SEO-optimized dengan struktur heading kompleks, perlu dilakukan review mandiri.

    Penutup & Kredit

    Eksperimen ini sebenarnya hanya nyambungin dua kerjaan orang lain dengan kabel pendek. Tanpa dua artikel/proyek di bawah ini, saya tidak akan bisa mencobanya. Terima kasih kepada:

    • 🙏 Pak Nugi (nugi.biz) — untuk panduan lengkap setup Claude Code gratis pakai NVIDIA NIM. Tutorialnya rapi, ada troubleshooting, dan langsung saya pakai tanpa perlu nyari ke sumber lain.
    • 🙏 Mas Afatyo (github.com/afatyoo) — untuk plugin wp-blog-abilities yang membungkus operasi blog jadi MCP abilities yang bersih dan aman. Permission callback-nya ketat, sanitasi input lengkap, dan README-nya termasuk dokumentasi yang rapi.
    • 🙏WordPress –  MCP Adapter  — untuk plugin MCP Adapter

    Kalau Anda merasa terbantu seperti saya, bisa mampir ke blog Pak Nugi dan bintangi repo Mas Afatyo di GitHub, kontribusi seperti ini yang membuat dunia per-IT-an menjadi lebih hidup.

    Selamat ngeblog dari terminal!


    Disclaimer percobaan: Saya jalankan setup ini hanya di lingkungan pribadi untuk eksperimen. Untuk pemakaian produksi atau yang melibatkan data sensitif, pertimbangkan pakai API Anthropic resmi (atau LLM lain yang Anda host sendiri) supaya privasi data dan kualitas output bisa dikontrol penuh.

    Tulisan ini dibuat oleh AI

  • Mengatasi Mismatch Versi DRBD di LINSTOR

    Mengatasi Mismatch Versi DRBD di LINSTOR

    Beberapa waktu terakhir saya sedang mendalami implementasi storage terdistribusi menggunakan LINSTOR di cluster Proxmox VE. Tujuannya sederhana: membuat storage yang bisa direplikasi antar node (HA) sehingga VM tetap aman walaupun salah satu node mati. Semua setup awal terlihat normal—node sudah terdaftar, storage pool sudah dibuat, dan integrasi ke Proxmox juga sudah masuk.

    Namun saat mencoba clone VM ke storage LINSTOR, muncul error autoplace yang cukup membingungkan. Setelah ditelusuri, ternyata akar masalahnya bukan di konfigurasi storage pool atau resource group, melainkan di layer yang lebih dalam: versi DRBD yang tidak selaras antara kernel dan userspace. Di sinilah perjalanan troubleshooting dimulai.


    Mengenal DRBD dan LINSTOR

    Sebelum masuk ke teknis, kita pahami dulu perannya:

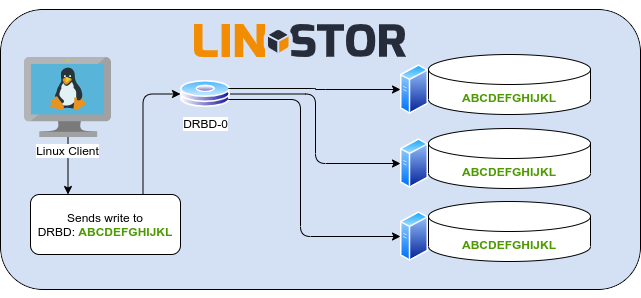
    • DRBD adalah teknologi replikasi block storage (mirip RAID 1 tapi via network).
    • LINSTOR adalah orchestrator yang mengatur DRBD secara otomatis di banyak node.

    Secara sederhana:

    • DRBD = mesin replikasi
    • LINSTOR = otaknya

    LINSTOR tidak menyimpan data sendiri, tapi memanfaatkan DRBD untuk membuat disk yang direplikasi antar node.


    Masalah yang Terjadi

    Saat melakukan pengecekan:

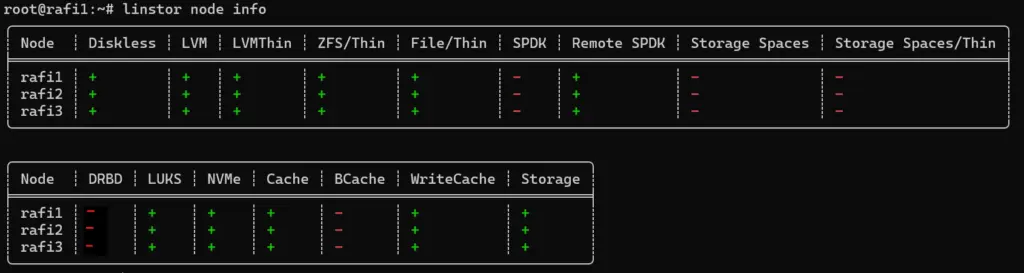
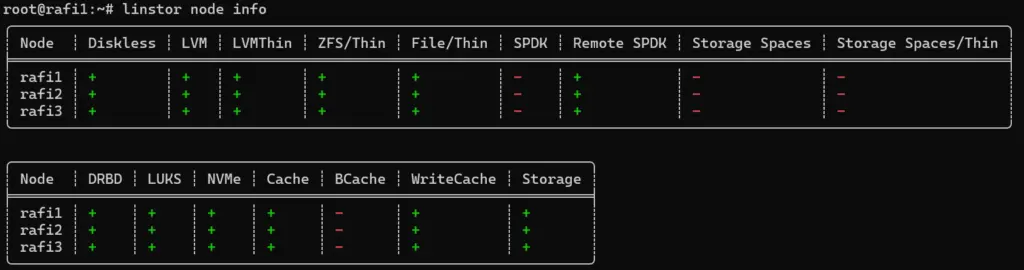
    linstor node info

    Hasilnya:

    Padahal:

    • drbdadm ada
    • modprobe drbd berhasil
    • service linstor jalan normal

    Pas dicek lebih dalam:

    cat /proc/drbd

    Output:

    version: 8.4.11 ()

    Sementara:

    dkms status

    Output:

    drbd/9.3.2-1, 7.0.0-3-pve, x86_64: installed ()

    Intinya

    Terjadi mismatch versi DRBD:

    KomponenVersi
    Kernel moduleDRBD 8 ❌
    UserspaceDRBD 9 ✔️

    Masalahnya:

    • LINSTOR hanya support DRBD 9
    • DRBD 8 dianggap tidak ada

    Kenapa Bisa Terjadi?

    Kernel Proxmox secara default masih membawa DRBD 8. Saat menjalankan:

    modprobe drbd

    Yang ter-load bukan DRBD 9 dari DKMS, tapi DRBD 8 bawaan kernel

    Akibatnya:

    • DRBD terlihat “aktif”
    • tapi tidak usable oleh LINSTOR

    Solusi: Selaraskan Versi DRBD

    Berikut langkah yang saya lakukan untuk memperbaiki mismatch ini.


    1. Blacklist DRBD lama (bawaan kernel)

    echo "blacklist drbd" > /etc/modprobe.d/blacklist-drbd.conf

    2. Update initramfs

    update-initramfs -u

    3. Reboot semua node

    reboot

    Lakukan di semua node cluster


    4. Load ulang DRBD

    modprobe drbd

    5. Verifikasi versi DRBD

    cat /proc/drbd

    Hasil yang benar:


    6. Restart LINSTOR

    systemctl restart linstor-satellite
    systemctl restart linstor-controller

    7. Cek ulang LINSTOR

    linstor node info

    Hasil:


    Hasil Akhir

    Setelah versi DRBD selaras:

    • Clone VM berhasil
    • Resource bisa autoplace ke semua node
    • Replikasi berjalan normal

    Error sebelumnya hilang

    does not support the following layers: [DRBD]

    Insight Penting (Pelajaran yang Didapat)

    Beberapa hal penting yang saya pelajari dari kasus ini:

    • DRBD harus versi yang sama untuk LINSTOR
    • modprobe drbd tidak menjamin versi yang digunakan benar
    • Selalu cek versi dari drbd di /proc/drbd
    • Kernel module bisa override DKMS jika tidak di-blacklist
    • LINSTOR sangat bergantung pada layer DRBD yang valid

    Kesimpulan

    Masalah yang terlihat seperti error konfigurasi LINSTOR ternyata berasal dari layer paling bawah: kernel module DRBD. Ini menunjukkan bahwa dalam implementasi storage terdistribusi, setiap layer harus selaras—mulai dari kernel, userspace, hingga orchestration.

    Dengan memastikan DRBD versi 9 aktif di semua node, LINSTOR dapat bekerja optimal dan seluruh fitur seperti replication, HA, dan cloning bisa berjalan dengan lancar.

  • Membuat Linux Bond dan Linux Bridge di Proxmox VE

    Membuat Linux Bond dan Linux Bridge di Proxmox VE

    Salah satu keuntungan menggunakan Proxmox VE sebagai hypervisor adalah fleksibilitas konfigurasi jaringannya. Kita bisa membuat bonding antar NIC fisik untuk mendapatkan redundansi atau agregasi bandwidth, lalu menempatkan bridge virtual di atasnya agar bisa dipakai oleh VM. Di tulisan ini saya akan dokumentasikan prosesnya step by step, mulai dari kondisi awal sampai bridge baru siap digunakan oleh VM.


    Kondisi Awal Jaringan

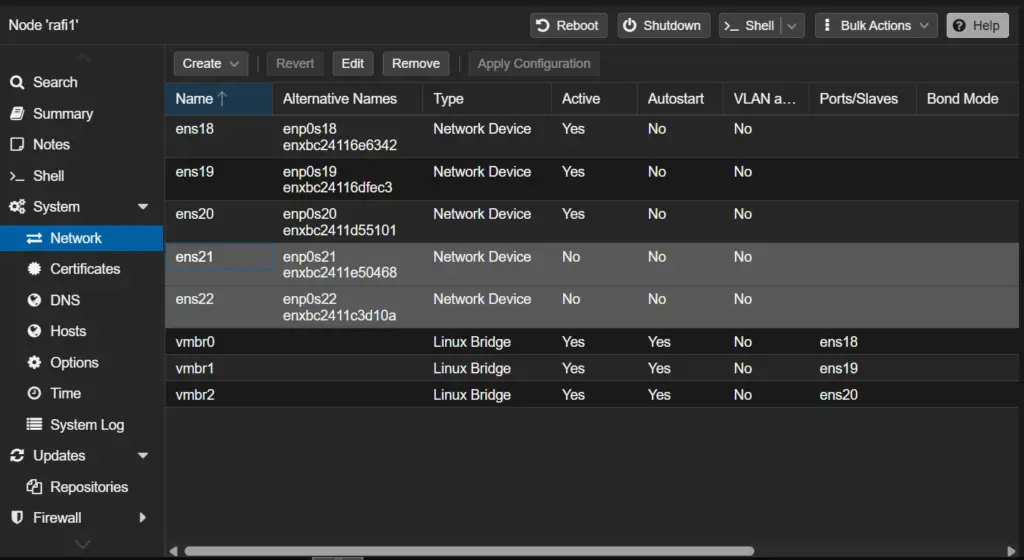
    Node Proxmox saya (rafi1) sudah punya beberapa antarmuka jaringan yang aktif. Tiga NIC fisik pertama sudah terpasang masing-masing ke bridge Linux tersendiri:

    • ens18 → vmbr0
    • ens19 → vmbr1
    • ens20 → vmbr2

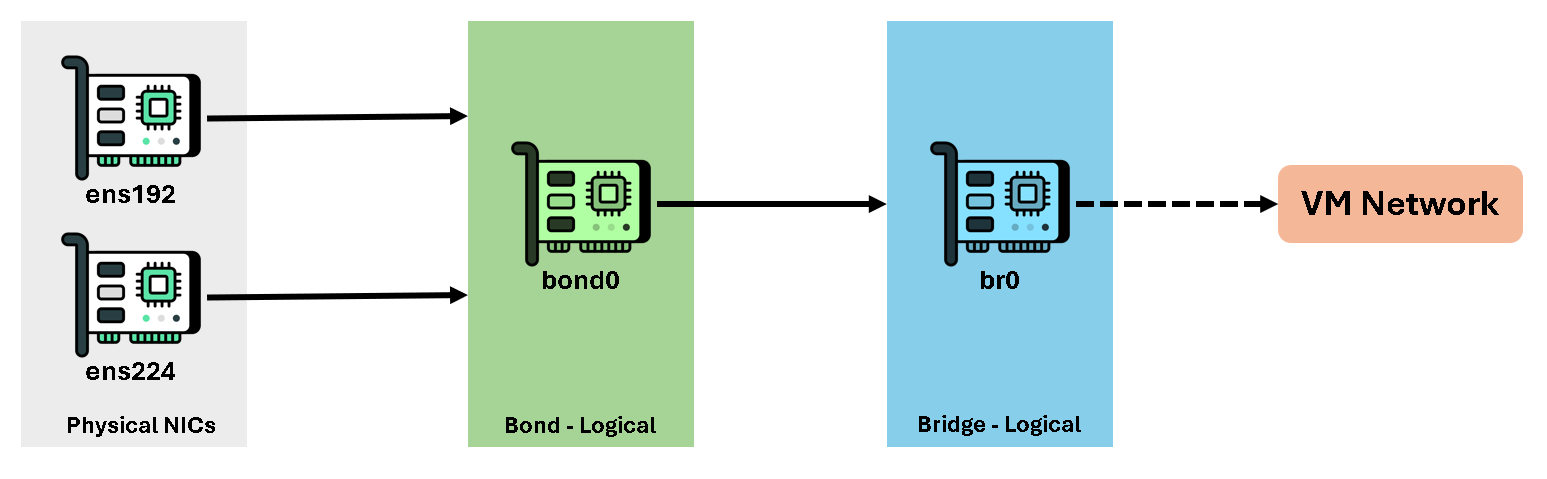
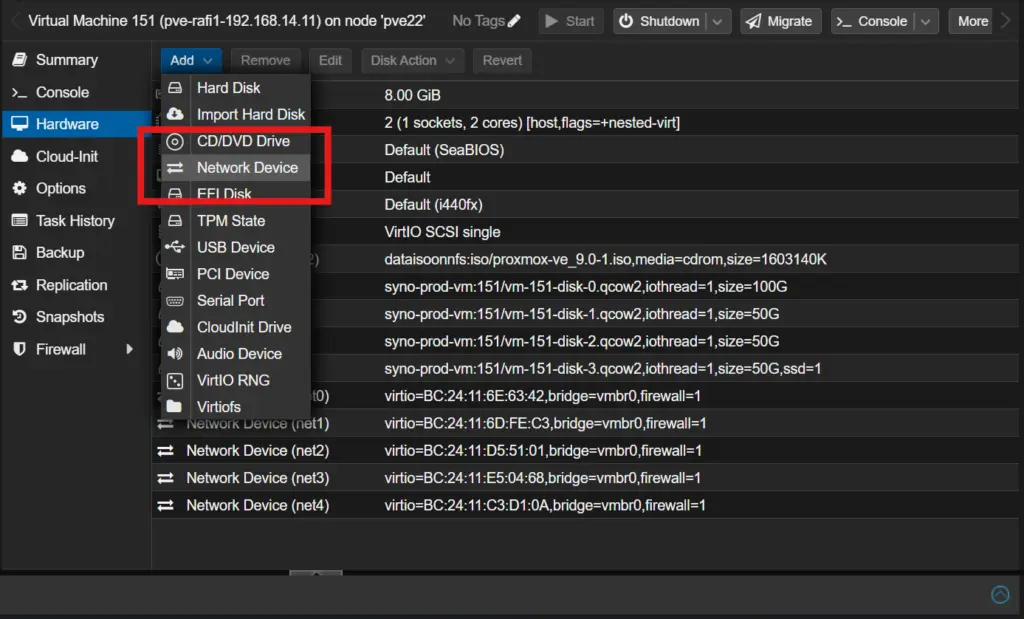
    Kemudian saya menambahkan 2 NIC, kedua NIC ini akan saya gabungkan menggunakan Linux Bond, lalu di atasnya saya buatkan sebuah bridge baru.

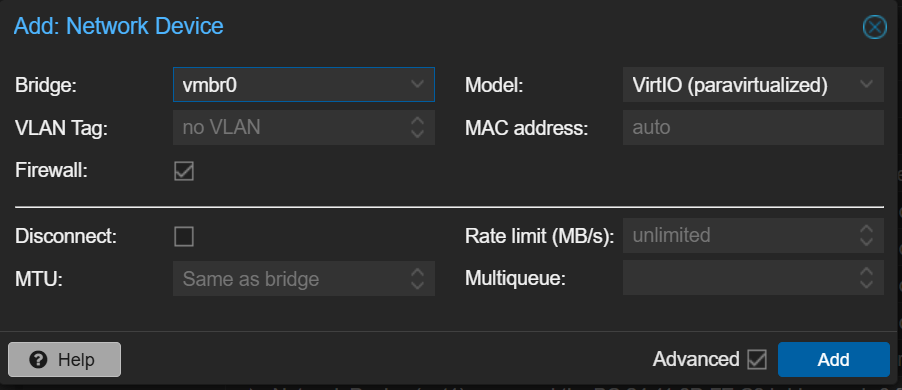
    Add -> Network Device

    Klik Add (biarkan default)

    ens 21 dan ens 22 siap di bond


    Mengapa Menggunakan Linux Bond?

    Linux Bonding memungkinkan kita menggabungkan dua atau lebih NIC fisik menjadi satu antarmuka logis. Ada beberapa mode yang tersedia, dan masing-masing punya karakteristik berbeda. Mode balance-rr (round-robin) bekerja dengan mendistribusikan paket secara bergantian ke semua slave interface. Hasilnya adalah peningkatan throughput sekaligus toleransi terhadap kegagalan salah satu link.


    Langkah 1: Membuat Linux Bond

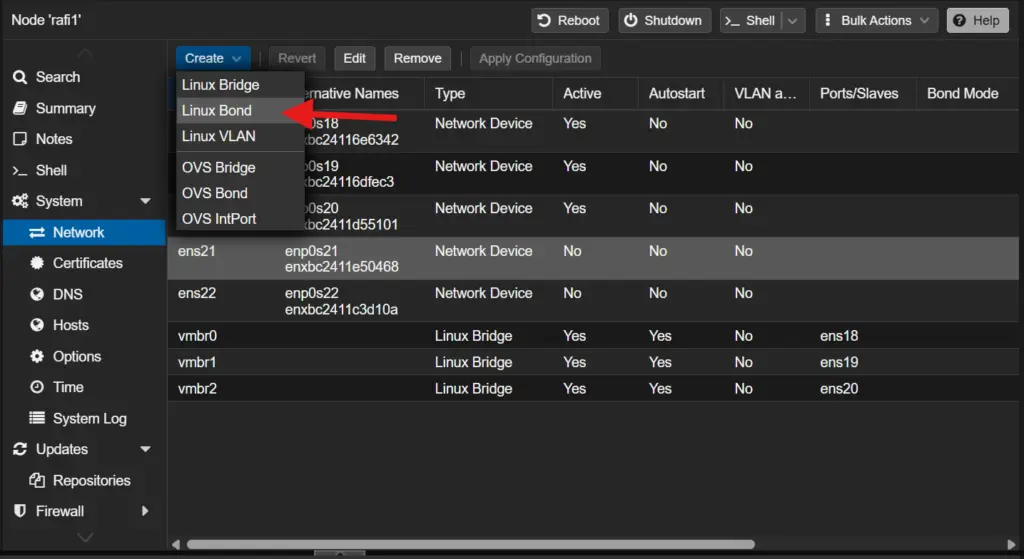
    Dari panel navigasi Proxmox, buka System → Network pada node yang dituju. Klik tombol Create lalu pilih Linux Bond.

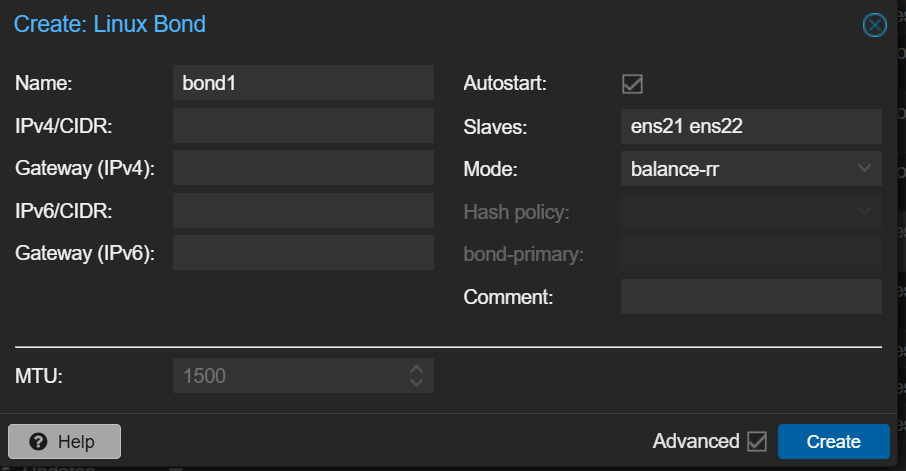
    Isi konfigurasi bonding dengan parameter berikut:

    • Name: bond0
    • Slaves: ens21 ens22 (pisahkan dengan spasi)
    • Mode: balance-rr
    • Autostart: aktifkan

    Tidak perlu mengisi IP/CIDR di sini karena bond ini akan berfungsi sebagai port untuk bridge, bukan sebagai antarmuka yang berdiri sendiri dengan alamat IP. Klik Create.

    Catatan: Jangan assign IP langsung ke bond interface jika bond tersebut akan digunakan sebagai bridge port. IP sebaiknya dilekatkan ke bridge-nya saja, bukan ke slave-nya. Ini menghindari konflik routing dan perilaku yang tidak terduga.


    Langkah 2: Apply Configuration

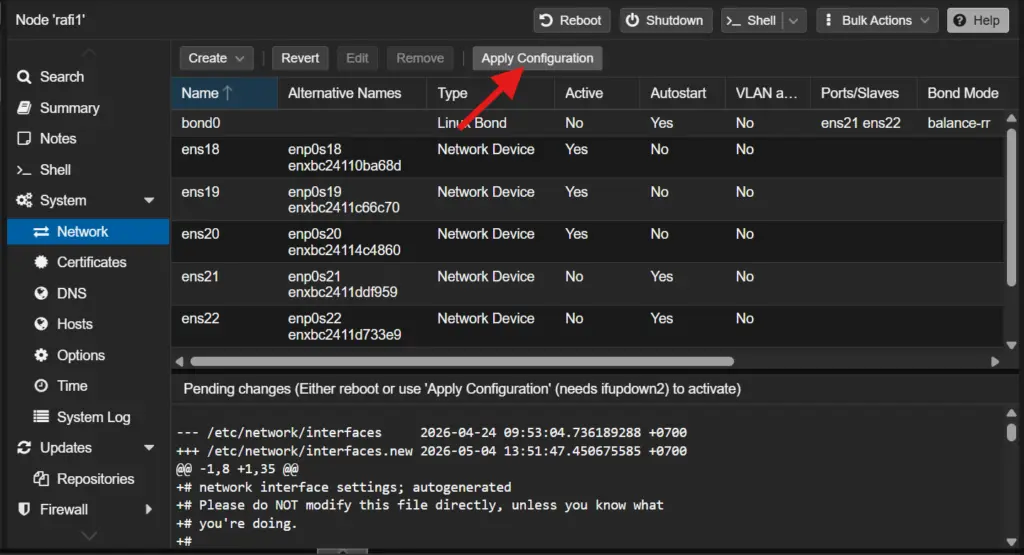
    Setelah bond dibuat, Proxmox akan menampilkan notifikasi Pending changes di bagian bawah halaman Network. Ini adalah diff dari file /etc/network/interfaces yang akan diterapkan. Proxmox menggunakan pendekatan ini agar kita bisa review perubahan sebelum diterapkan, sehingga risiko kehilangan koneksi ke node bisa diminimalkan.

    Klik tombol Apply Configuration untuk menerapkan perubahan tanpa harus reboot. Proxmox akan memanggil ifupdown2 di balik layar untuk mengaktifkan konfigurasi baru secara live.

    Setelah berhasil, bond0 akan muncul di daftar dengan tipe Linux Bond, status Active: No (karena belum ada traffic atau bridge yang menggunakannya), dan kolom Ports/Slaves menampilkan ens21 ens22.


    Langkah 3: Membuat Linux Bridge di Atas Bond

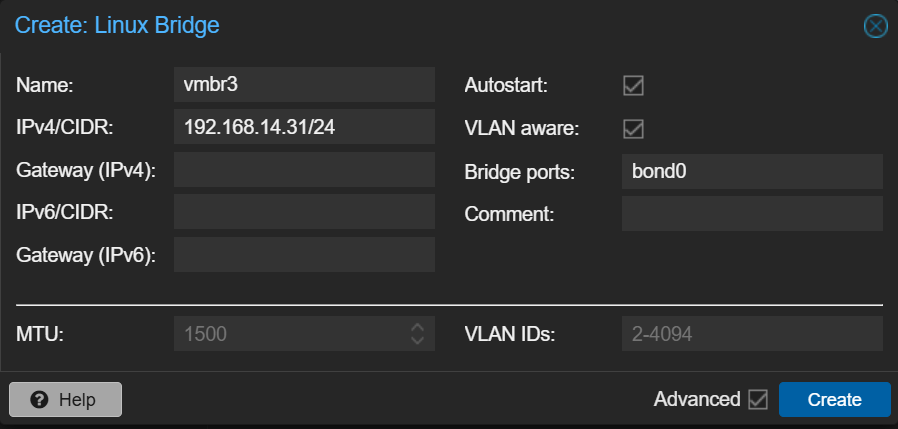
    Sekarang saatnya membuat bridge yang akan digunakan oleh VM. Klik Create → Linux Bridge, lalu isi dengan konfigurasi berikut:

    • Name: vmbr3
    • IPv4/CIDR: 192.168.14.31/24 (local)
    • Bridge ports: bond0
    • Autostart: aktifkan
    • VLAN aware: aktifkan

    Beberapa poin penting dari konfigurasi ini:

    • Gateway tidak diisi. Karena ini bukan interface manajemen utama, gateway tidak diperlukan di sini. Jika diisi sembarangan, bisa menyebabkan konflik default route dengan interface manajemen yang sudah ada.
    • VLAN aware diaktifkan. Ini adalah best practice di Proxmox. Dengan VLAN aware bridge, kita bisa mengatur VLAN tag langsung dari konfigurasi VM tanpa perlu membuat bridge terpisah untuk setiap VLAN. Range default VLAN ID yang diizinkan adalah 2-4094.
    • Bridge port diisi dengan bond0, bukan NIC fisik langsung. Ini yang membedakan dengan setup sebelumnya. Alih-alih menghubungkan bridge langsung ke NIC, kita melapisinya dengan bond terlebih dahulu sehingga bridge mendapat manfaat dari bonding.

    Ringkasan Arsitektur

    Setelah semua langkah selesai, arsitektur jaringan pada node rafi1 menjadi seperti ini:

    
    ens21 ─┐
           ├─► bond0 (balance-rr) ─► vmbr3 (IP, VLAN aware)
    ens22 ─┘
    

    VM yang terhubung ke vmbr3 akan menggunakan kedua NIC fisik secara bergantian, sehingga mendapatkan bandwidth yang lebih besar dan tetap terhubung selama salah satu link masih hidup.


    Hal yang Perlu Diperhatikan

    Balance-rr mendistribusikan paket secara round-robin di level paket, bukan per-flow. Ini bisa menyebabkan paket tiba di tujuan dengan urutan yang tidak sesuai, yang pada beberapa skenario bisa menurunkan performa TCP. Jika switch mendukung LACP, pertimbangkan untuk beralih ke mode 802.3ad dengan hash policy layer2+3 atau layer3+4 agar distribusi traffic lebih stabil dan tidak mengganggu urutan paket.

    Selain itu, pastikan kedua NIC slave (ens21 dan ens22) terhubung ke switch yang sama atau trunk yang sama agar bonding bekerja dengan benar. Bonding lintas switch (multi-chassis) membutuhkan konfigurasi tambahan di level switch yang lebih kompleks.


    Penutup

    Untuk selanjutnya, mungkin saya akan menulis bagaimana setup network bridge tersebut agar support VLAN dengan setup VLAN 20. Kemudian untuk setup Proxmox SDN (menggunakan vxlan). Terakhir, coba aplikasikan network pada lxc dan kvm yang ada. Terima kasih sudah membaca.