Kemarin saya mengikuti webinar partner training yang membahas pembaruan NAKIVO Backup & Replication v11.3 Beta. Dari beberapa fitur yang diperkenalkan, saya lebih memperhatikan bagian Proxmox karena platform ini cukup sering saya gunakan di lab.
Pembaruan yang paling saya kenal yaitu migrasi VM dari VMware, pengelolaan backup, dan recovery ketika VM utama bermasalah.
1. Migrasi VMware ke Proxmox VE
NAKIVO memperkenalkan kemampuan memulihkan backup VM VMware menjadi VM Proxmox VE. Artinya, backup yang sudah tersedia dapat digunakan sebagai jalur migrasi antarplatform.
Gambaran alurnya:
VM VMware memiliki backup di NAKIVO.
Backup tersebut digunakan sebagai sumber recovery.
VM dipulihkan ke lingkungan Proxmox VE.
Ini menarik karena memberikan pilihan pemindahan VM melalui backup tanpa membangun ulang VM dari awal. Pembahasannya juga dekat dengan kegiatan saya yang sedang mempelajari migrasi dari VMware ke platform berbasis KVM.
2. Disaster Recovery untuk Proxmox
Dukungan Proxmox diperluas dengan failover, failback, dan Site Recovery. Ketiganya memiliki fungsi yang saling melengkapi:
Failover: menjalankan layanan dari VM replica ketika VM utama tidak tersedia.
Failback: mengembalikan layanan dari lingkungan pemulihan ke sistem utama setelah siap digunakan.
Site Recovery: menyusun dan menjalankan proses pemulihan beberapa VM sesuai urutan yang ditentukan.
Contohnya, jika suatu aplikasi membutuhkan beberapa VM, urutan pemulihannya dapat disusun dalam recovery plan. Pengujian disaster recovery juga dapat dijadwalkan atau dijalankan sesuai kebutuhan.
Bagian ini relevan untuk memahami bagaimana VM replica digunakan saat terjadi gangguan, sekaligus bagaimana proses kembali ke sistem utama diatur.
3. Backup Proxmox Berdasarkan Policy
Fitur policy-based data protection diperluas ke Proxmox VE. Administrator dapat membuat aturan agar VM yang memenuhi kriteria otomatis masuk ke job backup dan replication.
Manfaatnya untuk pengelolaan VM:
Mengurangi penambahan VM ke job secara manual.
Membantu menjaga cakupan backup ketika jumlah VM bertambah.
Mengurangi pekerjaan penyesuaian job saat lingkungan berubah.
Fitur ini lebih terasa manfaatnya ketika VM sudah cukup banyak dan pengelolaan job satu per satu mulai merepotkan.
4. Pembaruan Lainnya
Selain bagian Proxmox, webinar juga memperkenalkan:
Ransomware Detection: pemindaian backup untuk membantu mengidentifikasi recovery point tanpa ancaman yang terdeteksi.
HPE VM Essentials: tambahan dukungan backup dan recovery untuk platform tersebut.
IBM AIX: dukungan backup dan recovery file serta folder.
Ada juga pembahasan perpindahan Exchange Online dari EWS ke Microsoft Graph API. Dukungan Graph API sudah diperkenalkan pada v11.2.3 dan kembali dibahas untuk kelangsungan backup Microsoft 365.
Catatan: pada materi webinar, akses v11.3 Beta masih tertulis Coming Soon dan melalui undangan. Fitur yang dibahas masih berupa preview.
Beberapa waktu lalu saya diminta melakukan pengujian migrasi NAKIVO Backup & Replication ke server baru. Tujuan pengujian ini adalah memastikan apakah konfigurasi seperti inventory, credentials, job backup, job replikasi, dan schedule dapat dipindahkan tanpa harus dibuat ulang.
Pengujian dilakukan menggunakan dua server, yaitu nakivo sebagai server lama dan nakivo2 sebagai server baru. Inventory yang dikelola terdiri dari dua server Proxmox, yaitu pve-nakivo dan pve-nakivo2, dengan backup tersimpan pada Onboard Repository.
Memahami Cakupan System Configuration
NAKIVO menyediakan fitur Export System Configuration untuk memindahkan konfigurasi Director ke instance baru. Berdasarkan dokumentasi NAKIVO, konfigurasi yang ikut dipindahkan mencakup inventory, job, credentials, dan Transporter settings.
Pada pengujian ini, konfigurasi berikut berhasil terbawa ke NAKIVO baru:
Inventory Proxmox yang sudah didaftarkan.
Credentials.
Backup job dan replication job.
Schedule dan retention setiap job.
Konfigurasi Transporter.
Referensi atau konfigurasi Backup Repository.
Namun, export system configuration tidak membawa data fisik yang tersimpan di Backup Repository. Artinya, file backup dan recovery point tetap berada di storage server lama dan harus dipindahkan secara terpisah.
Fitur ini juga ditujukan untuk migrasi, bukan sebagai backup konfigurasi rutin. Saat export dilakukan, aktivitas yang sedang berjalan akan dihentikan dan seluruh job pada NAKIVO lama akan dinonaktifkan. Setelah export, sebaiknya jangan menjalankan kembali job pada instance lama jika migrasi akan dilanjutkan ke instance baru.
Sebelum export, saya memastikan tidak ada proses backup, replikasi, recovery, maupun repository maintenance yang sedang berjalan.
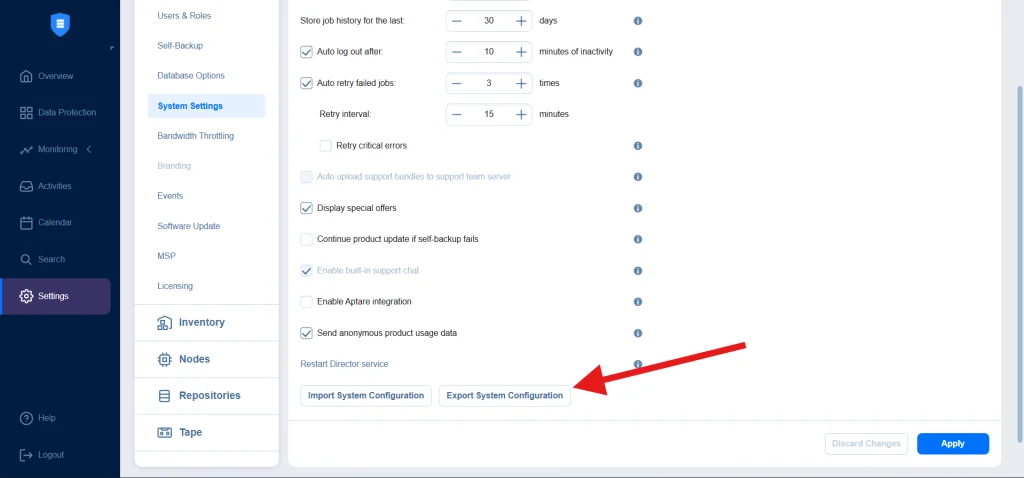
Proses export dilakukan melalui menu berikut:
Buka Settings.
Masuk ke General > System Settings.
Pilih tab Configuration.
Klik Export System Configuration.
Pilih Include indexing data jika data indexing juga ingin dipindahkan.
Pilih Encrypt system configuration untuk melindungi credentials di dalam bundle.
Masukkan password, kemudian jalankan export.
Download export bundle setelah proses selesai.
NAKIVO lama kemudian tidak digunakan untuk menjalankan job agar tidak terjadi perbedaan status antara Director lama dan Director baru.
Import Konfigurasi ke NAKIVO Baru
Pada nakivo2, saya memasang NAKIVO Backup & Replication dengan versi dan build yang sama. Import dilakukan melalui:
Buka Settings.
Masuk ke General > System Settings.
Pilih tab Configuration.
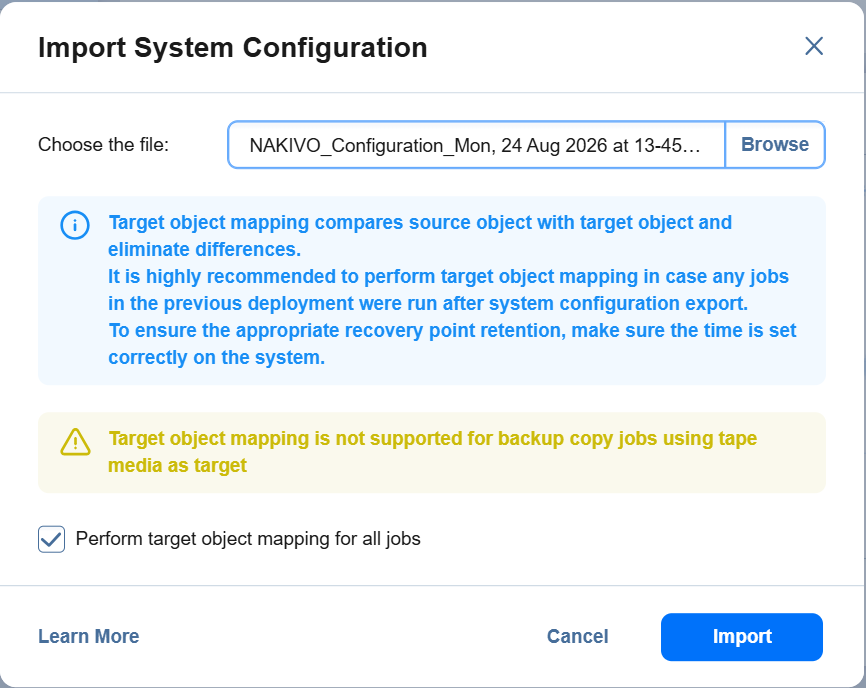
Klik Import System Configuration.
Pilih export bundle dari server lama.
Masukkan password bundle.
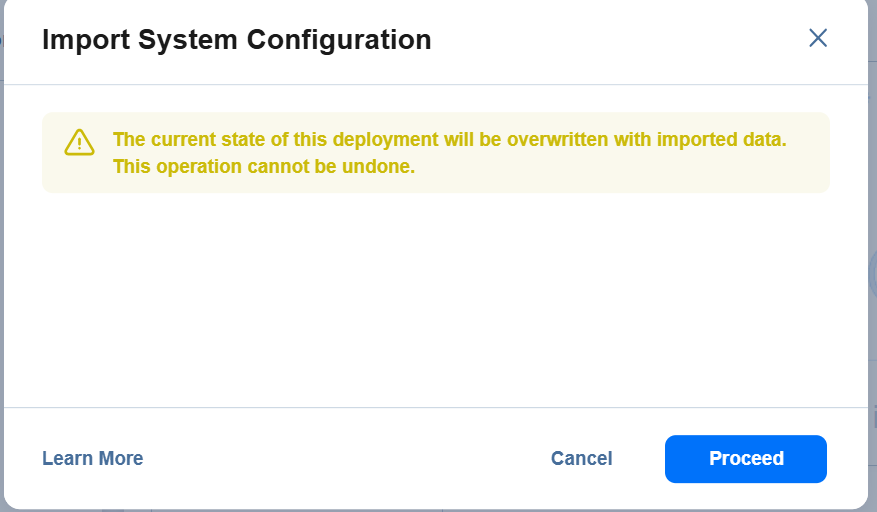
Klik Import, kemudian Proceed.
Setelah proses selesai, inventory, credentials, backup job, replication job, dan schedule dari NAKIVO lama muncul pada NAKIVO baru. Konfigurasi yang sudah ada sebelumnya pada server baru akan ditimpa oleh konfigurasi dari bundle.
Memindahkan Data Onboard Repository
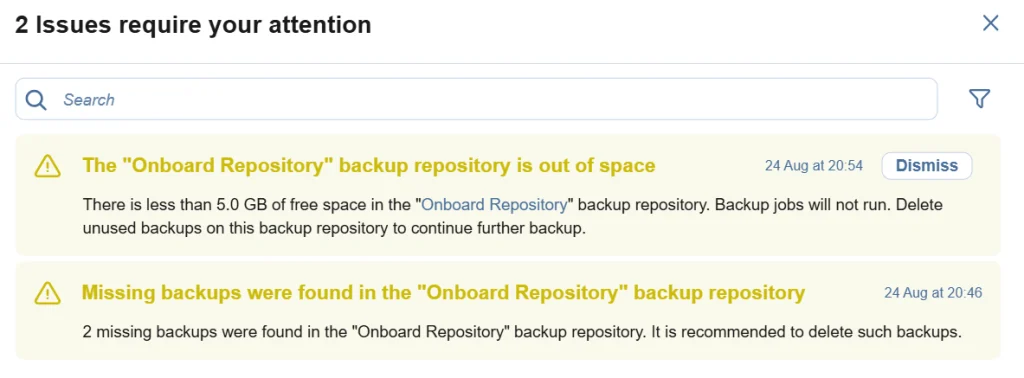
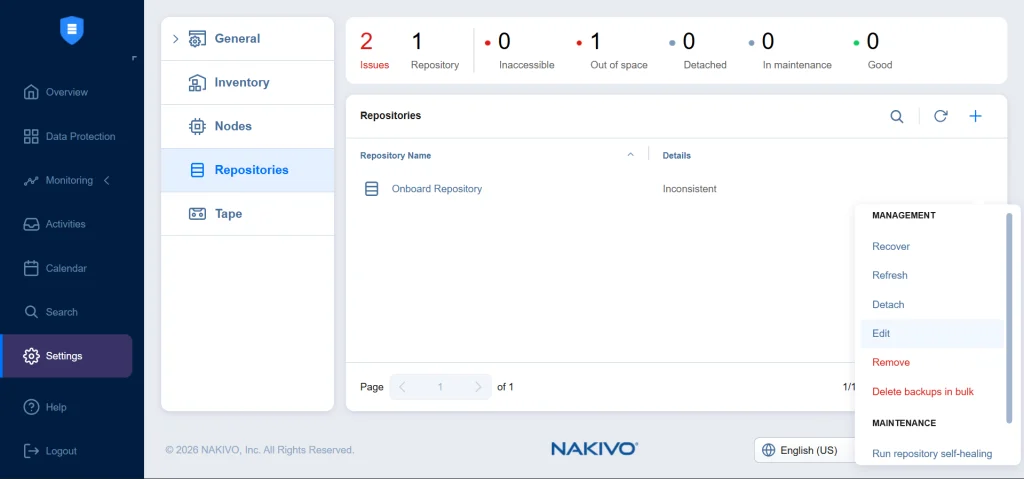
Walaupun konfigurasi repository sudah terbawa, data backup belum berada pada server baru. Dan masih menunjukkan issue
Lokasi repository pada server lama adalah:
/opt/nakivo/repository/NakivoBackup
Pada server baru, repository saya tempatkan di:
/backup-nakivo/NakivoBackup
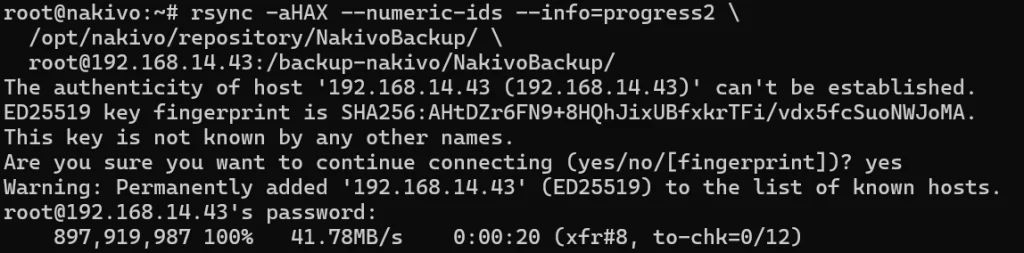
Sebelum menyalin data, repository harus dipastikan tidak sedang digunakan oleh job dan sebaiknya di-detach terlebih dahulu. Seluruh folder NakivoBackup kemudian disalin tanpa mengubah atau menghapus file di dalamnya.
Saya memilih menyalin data terlebih dahulu, bukan langsung menghapus repository lama. Dengan demikian, salinan lama masih dapat digunakan sebagai cadangan sampai repository baru berhasil diverifikasi.
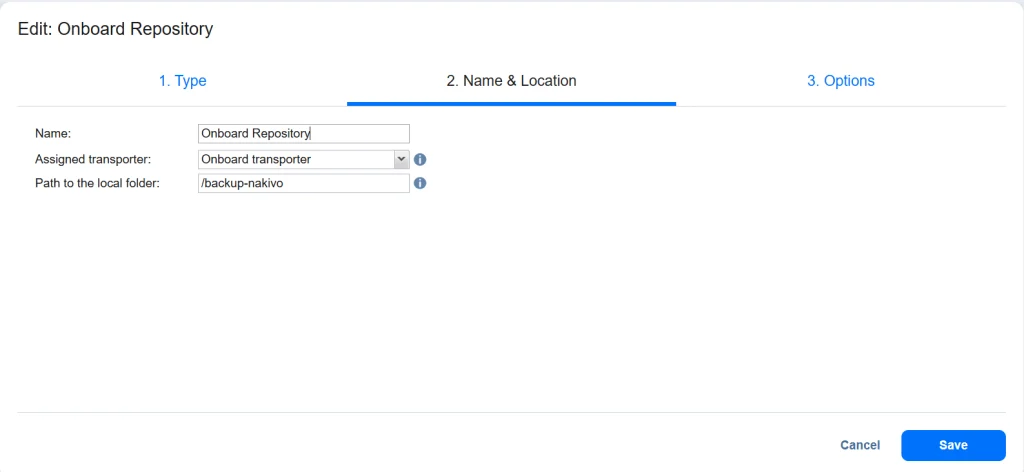
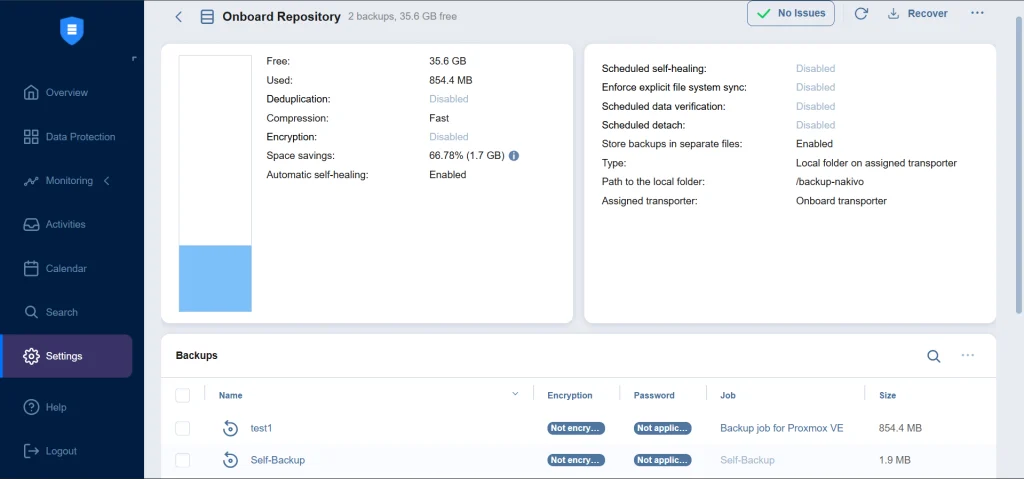
Repository hasil import kemudian diedit melalui Settings > Repositories. Assigned Transporter diarahkan ke Onboard Transporter milik nakivo2, sedangkan path diisi dengan:
/backup-nakivo
Path yang dimasukkan adalah direktori induk, bukan /backup-nakivo/NakivoBackup, karena NAKIVO akan mencari folder NakivoBackup di dalam lokasi tersebut.
Jika repository tidak muncul setelah import, repository dapat didaftarkan melalui Settings > Repositories > Add existing backup repository. Pilih Local Folder, tentukan Transporter, lalu masukkan path /backup-nakivo.
Saat menjalankan self-healing, muncul error berikut:
Self-healing of the "Onboard Repository" has failed

Reason: The "Onboard transporter" transporter cannot read and/or
write to the specified location (/backup-nakivo).
Pemeriksaan permission menunjukkan kondisi berikut:
# Server lama
drwxrwxrwx root  root  /opt/nakivo/repository
drwxrwx--- bhsvc bhsvc /opt/nakivo/repository/NakivoBackup

# Server baru
drwxr-xr-x root  root  /backup-nakivo
drwxrwx--- bhsvc bhsvc /backup-nakivo/NakivoBackup
Folder NakivoBackup sudah dimiliki oleh bhsvc, tetapi folder induk /backup-nakivo masih dimiliki root:root dengan permission 755. Akibatnya, Onboard Transporter dapat membuka folder tersebut, tetapi tidak memiliki hak tulis pada lokasi yang didaftarkan sebagai repository.
Permission dapat disamakan seperti server lama menggunakan chmod 777, tetapi pilihan yang lebih aman adalah memberikan akses hanya kepada user dan grup service NAKIVO:
Sebelum mengaktifkan kembali seluruh schedule, beberapa pemeriksaan yang perlu dilakukan adalah:
Inventory Proxmox dapat di-refresh.
Onboard Transporter berstatus online.
Repository berstatus attached dan accessible.
Backup VM serta recovery point lama dapat ditampilkan.
Self-healing selesai tanpa error.
Satu file atau VM dapat dipulihkan sebagai pengujian.
Satu backup job dapat dijalankan secara manual.
Satu replication job dapat dijalankan secara manual.
Schedule berjalan dari NAKIVO baru tanpa ada job aktif pada NAKIVO lama.
Kesimpulan
Dari pengujian ini, export dan import system configuration dapat memindahkan konfigurasi utama NAKIVO seperti inventory, credentials, job backup, job replikasi, dan schedule. Namun, proses tersebut tidak memindahkan data fisik pada Onboard Repository.
Data repository tetap harus disalin atau dipindahkan secara manual, kemudian path, Assigned Transporter, ownership, dan permission disesuaikan pada server baru. Hal penting yang saya temukan adalah permission folder NakivoBackup saja belum cukup; user bhsvc juga harus memiliki akses baca dan tulis pada direktori induk yang didaftarkan sebagai lokasi repository.
Dalam pengujian NAKIVO Backup & Replication, saya menemukan bahwa replikasi VM Proxmox kembali menjadi full setelah VM sempat reboot. Kondisi ini berkaitan dengan Change Block Tracking (CBT) dan format disk yang digunakan.
Homelab yang Digunakan
Pengujian menggunakan dua node Proxmox:
pve-nakivo sebagai source
pve-nakivo2 sebagai destination
Ceph RBD sebagai backend storage
VM test1 sebagai objek replikasi
Replikasi dijalankan dari pve-nakivo menuju pve-nakivo2 melalui schedule NAKIVO.
Hasil Pengujian
Pengujian dilakukan dengan urutan berikut:
Replikasi pertama dijalankan saat VM menyala.
NAKIVO menjalankan full replication.
VM kemudian di-reboot.
Schedule replikasi berikutnya kembali berjalan.
Replikasi kedua juga dijalankan secara full.
Pada job kedua, muncul warning:
Proxmox VE CBT data was not provided for the “test1” VM.
Kemudian NAKIVO menampilkan informasi:
Cannot perform incremental replication of the “test1” VM.
Artinya, schedule replikasi tetap berjalan. Namun, NAKIVO tidak dapat melanjutkan incremental replication karena informasi perubahan disk sebelumnya tidak tersedia.
Penyebabnya
CBT digunakan untuk mencatat blok disk yang berubah sejak replikasi terakhir. Dengan informasi tersebut, NAKIVO hanya perlu mengirimkan data yang berubah.
Menurut dokumentasi NAKIVO:
Disk format QEMU/QCOW2 memiliki dirty bitmap yang persistent.
Disk format RAW atau VMDK menggunakan dirty bitmap non-persistent.
Reboot VM dengan disk RAW akan me-reset dirty bitmap.
Pada homelab ini, disk VM disimpan pada Ceph RBD. Ceph RBD merupakan block-level storage dan VM disk menggunakan format RAW. Ketika VM reboot, data CBT di-reset sehingga NAKIVO tidak mendapatkan informasi perubahan blok yang valid.
NAKIVO kemudian mencoba menggunakan proprietary change tracking. Namun, karena informasi increment sebelumnya tidak ditemukan, NAKIVO menjalankan full replication kembali.
Pengujian Lanjutan
Untuk memastikan incremental replication berjalan normal, pengujian dapat dilanjutkan dengan skenario berikut:
Jalankan full replication.
Tambahkan data pada VM tanpa melakukan reboot.
Tunggu schedule berikutnya.
Pastikan job berjalan secara incremental.
Reboot VM dan tunggu schedule selanjutnya.
Bandingkan hasil replikasi setelah reboot.
Untuk VM yang sering reboot, opsi Use proprietary method dapat digunakan pada pengaturan Change Tracking. Metode ini tidak bergantung sepenuhnya pada native CBT Proxmox, tetapi prosesnya lebih lama karena NAKIVO perlu membaca seluruh disk untuk mencari blok yang berubah.
QEMU Guest Agent tetap perlu dipasang untuk proses snapshot dan quiescing guest OS, tetapi tidak dapat mencegah CBT ter-reset setelah VM reboot.
Kesimpulan
Schedule replikasi tetap berjalan meskipun VM sempat reboot. Namun, pada VM yang menggunakan Ceph RBD dengan format RAW, reboot dapat me-reset CBT sehingga incremental replication tidak dapat dilanjutkan dan NAKIVO kembali menjalankan full replication.
Kondisi ini merupakan limitasi native CBT pada disk RAW, bukan kegagalan schedule replikasi.
NAKIVO dapat digunakan untuk membuat replica VM dari satu Proxmox ke Proxmox lainnya. Replica tersebut dapat dinyalakan ketika VM utama mengalami gangguan atau saat melakukan pengujian recovery.
Pada pengujian homelab ini, replication sempat gagal dan menghasilkan beberapa warning. Berikut konfigurasi yang saya lakukan agar prosesnya dapat berjalan dengan lancar.
Homelab yang Digunakan
Saya menggunakan dua server Proxmox dengan backend storage Ceph.
Komponen
Fungsi
pve-nakivo
Host VM sumber
pve-nakivo2
Host VM replica
Ceph RBD
Storage disk VM sumber dan replica
NAKIVO
Mengatur dan menjalankan proses replication
Alur replication-nya sebagai berikut:
    VM sumber
pve-nakivo + Ceph
        ↓
      NAKIVO
        ↓
    VM replica
pve-nakivo2 + Ceph
NAKIVO berperan memproses dan memindahkan data. Hasil akhirnya tetap berupa VM replica pada pve-nakivo2, bukan disimpan di server NAKIVO.
Sebelum menjalankan replication, ada empat hal yang perlu diperiksa.
1. Ubah Lokasi Temporary Overlay
Untuk VM yang berada pada block storage seperti Ceph RBD, NAKIVO membuat temporary overlay pada host Proxmox. Secara default, file tersebut disimpan di /tmp.
Pada pengujian pertama, replication gagal dengan error:
Host has no free space for overlay files
Not enough space for creation of temporary overlay file in "/tmp" location.
Periksa kapasitas /tmp pada pve-nakivo:
df -hT /tmp
findmnt -T /tmp
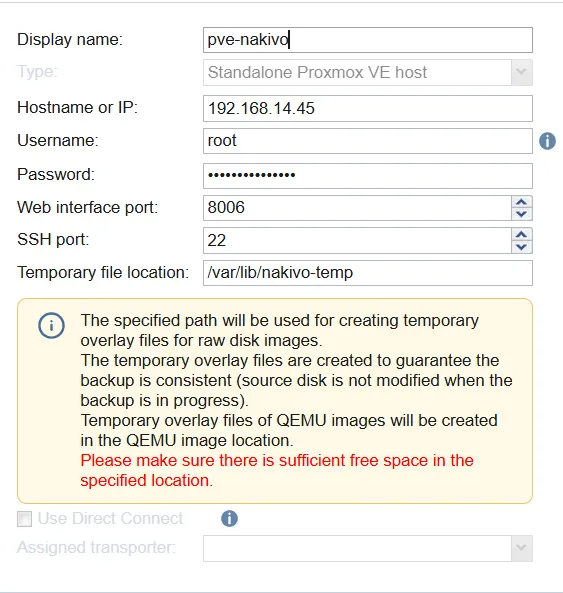
Pada homelab saya, /tmp menggunakan tmpfs dengan kapasitas 2 GB. Karena tidak cukup, saya membuat lokasi temporary baru pada filesystem root yang sudah memiliki ruang lebih besar:
Simpan konfigurasi lalu lakukan Refresh Inventory.
Untuk homelab, direktori tersebut cukup digunakan selama kapasitas root dipantau. Pada production, sebaiknya gunakan filesystem terpisah agar temporary overlay tidak memenuhi root Proxmox.
2. Pastikan VM Sumber Menyala
Pada pengujian berikutnya, replication VM yang sedang off dapat diproses oleh NAKIVO, tetapi menghasilkan warning karena VM dijalankan dalam temporary prelaunch state.
Untuk mendapatkan hasil job yang bersih, saya memastikan VM sumber sudah menyala sebelum replication dimulai:
qm list
qm start <VMID>
Pastikan status VM pada pve-nakivo menunjukkan running.
3. Pasang dan Aktifkan QEMU Guest Agent
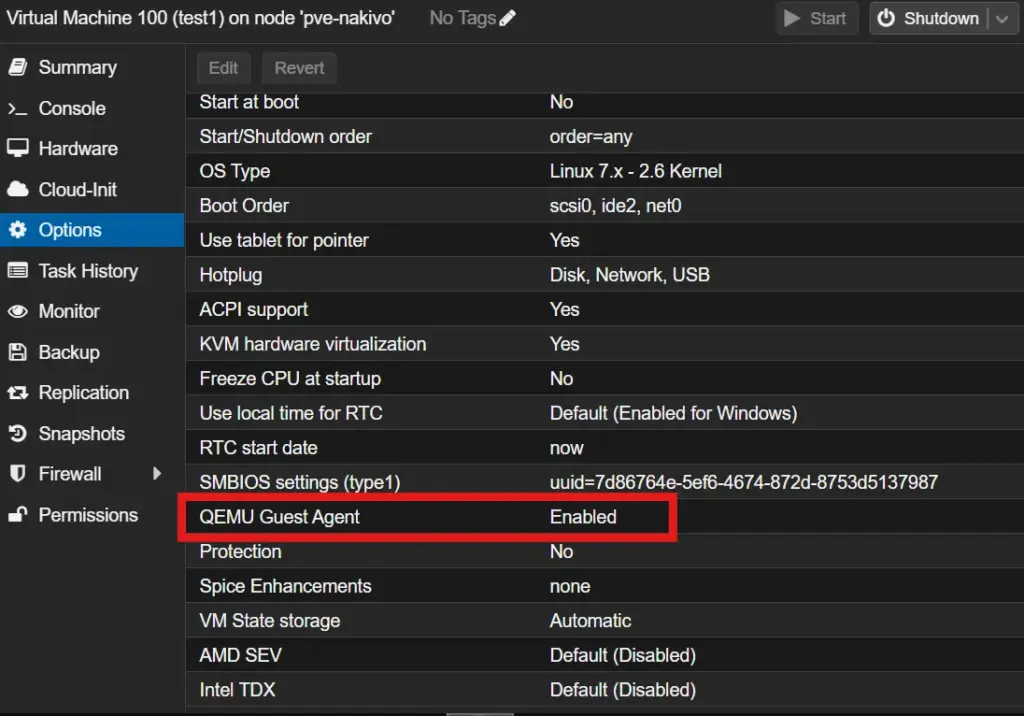
QEMU Guest Agent membantu Proxmox berkomunikasi dengan guest OS. NAKIVO membutuhkannya untuk melakukan guest OS quiescing agar filesystem berada dalam kondisi konsisten saat snapshot dibuat.
Tanpa agent, job dapat tetap berjalan tergantung konfigurasinya. Namun, dapat muncul warning karena quiesced snapshot tidak berhasil dibuat.
Jika agent baru diaktifkan tetapi belum terdeteksi, lakukan shutdown lalu start kembali VM. Uji komunikasinya dari host Proxmox:
qm agent <VMID> ping
Jika perintah tidak menghasilkan error, QEMU Guest Agent sudah terhubung.
4. Pisahkan Jadwal Backup dan Replication
Backup dan replication sebaiknya tidak dijalankan pada waktu yang sama. Keduanya menggunakan VM sumber, storage Ceph, jaringan, dan NAKIVO Transporter.
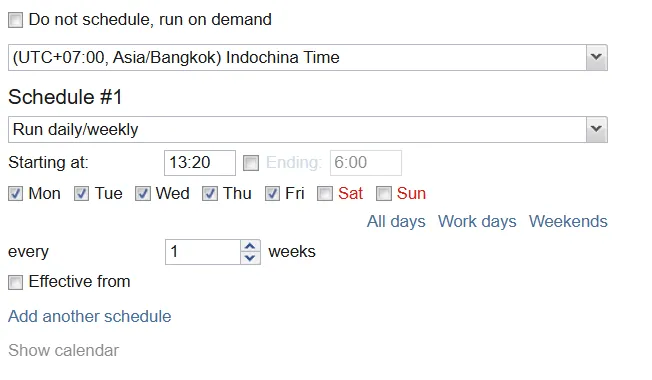
Pada homelab ini, jadwalnya dipisahkan seperti berikut:
Job
Contoh Jadwal
Backup
21.00 WIB
Replication
23.00 WIB
Berikan jeda sesuai durasi backup ditambah buffer. Pilihan yang lebih aman adalah menggunakan Run after another job, sehingga replication baru berjalan setelah backup selesai.
Periksa juga menu Calendar pada NAKIVO untuk memastikan tidak ada jadwal yang saling tumpang tindih.
Verifikasi Hasil Replication
Setelah konfigurasi diperbaiki, jalankan kembali job dan pastikan:
Job replication berstatus Successful tanpa error atau warning.
VM replica muncul pada pve-nakivo2.
Disk replica berada pada storage Ceph tujuan.
Temporary overlay dibersihkan setelah job selesai.
Penggunaan temporary storage dapat dipantau selama job berjalan:
watch -n 5 'df -h /var/lib/nakivo-temp; du -sh /var/lib/nakivo-temp 2>/dev/null'
Penutup
Replication NAKIVO pada Proxmox dapat berjalan lancar setelah lokasi temporary overlay memiliki ruang yang cukup, VM sumber dalam kondisi menyala, QEMU Guest Agent aktif, dan jadwal job tidak saling bertabrakan.
Empat pemeriksaan tersebut cukup sederhana, tetapi penting dilakukan sebelum replication diterapkan pada VM lainnya.
Saat melakukan pengujian replication NAKIVO pada Proxmox dengan backend storage Ceph, job gagal karena NAKIVO tidak memiliki ruang yang cukup untuk membuat temporary overlay. Masalah ini terjadi walaupun kapasitas Ceph masih tersedia.
Artikel ini membahas penyebabnya, proses pemeriksaan, dan solusi yang digunakan pada lab.
Kondisi Lab
Komponen
Konfigurasi
Proxmox
pve-nakivo.local
IP Proxmox
192.168.14.45
Disk OS awal
30 GB, ext4 dan LVM
Backend storage VM
Ceph
Ceph OSD
3 × 50 GB
VM pengujian
test1
VM sumber berada di Ceph, sedangkan replication dijalankan melalui NAKIVO.
Pesan Error
Pada replication pertama, NAKIVO menampilkan error berikut:
ReplicationDataCopy: Host has no free space for overlay files

Not enough space for creation of temporary overlay file in "/tmp" location.
Please make sure there is sufficient free space in the specified location.
Error tersebut menunjukkan bahwa masalah berada pada temporary file location di host Proxmox, bukan pada kapasitas Ceph.
Memahami Alur Replication NAKIVO
Pada storage berbasis block seperti Ceph RBD, NAKIVO membutuhkan overlay sementara selama pemrosesan VM.
VM test1 di Ceph
→ temporary overlay di host Proxmox
→ data diproses oleh NAKIVO
→ VM replica dibuat pada storage tujuan
→ temporary overlay dibersihkan
Jadi, /tmp bukan lokasi akhir replica. Hasil replication tetap berupa VM pada Proxmox dan storage tujuan yang dipilih dalam job.
Penyebab
Pada Proxmox VE 9, /tmp menggunakan tmpfs. Artinya, kapasitas /tmp berasal dari memory dan swap, bukan dari filesystem root.
Karena itu, memperbesar disk OS dan pve-root tidak otomatis menambah kapasitas /tmp. Root sudah memiliki ruang kosong 97 GB, tetapi NAKIVO masih menggunakan /tmp yang hanya 2 GB.
Memperbesar tmpfs juga bukan pilihan yang digunakan pada pengujian ini karena akan menambah batas penggunaan memory atau swap. Solusinya adalah membuat direktori temporary NAKIVO pada filesystem ext4 yang sudah diperbesar.
Simpan perubahan, kemudian lakukan Refresh Inventory.
Menjalankan Ulang Replication
Jalankan kembali replication job melalui NAKIVO. Selama proses berlangsung, kapasitas dan penggunaan direktori temporary dapat dipantau dengan:
watch -n 5 'df -h /var/lib/nakivo-temp; du -sh /var/lib/nakivo-temp 2>/dev/null'
Hasil yang diharapkan:
Job replication berstatus Successful.
VM replica muncul pada Proxmox.
Disk replica berada pada storage tujuan yang dipilih.
Temporary overlay dibersihkan setelah job selesai.
VM sumber tetap berjalan normal.
Catatan Penting
Penggunaan /var/lib/nakivo-temp sesuai untuk pengujian lab karena root sudah memiliki ruang yang cukup. Namun, direktori tersebut masih berada pada root volume Proxmox.
Untuk production atau VM dengan perubahan data tinggi, gunakan disk atau filesystem terpisah sebagai temporary file location. Tujuannya agar pertumbuhan overlay tidak memenuhi root dan mengganggu service Proxmox.
Selain itu, replication ke node dan Ceph yang sama hanya membuktikan fungsi replication. Skenario tersebut belum memberikan perlindungan disaster recovery karena VM sumber dan replica tetap bergantung pada host yang sama.
Kesimpulan
Replication gagal bukan karena Ceph kehabisan ruang, tetapi karena /tmp pada Proxmox hanya berupa tmpfs 2 GB. Memperbesar disk OS tidak menambah kapasitas /tmp secara otomatis.
Solusi pada lab ini adalah membuat /var/lib/nakivo-temp, kemudian mengarahkannya sebagai Temporary file location pada inventory NAKIVO. Dengan begitu, overlay dapat memakai ruang kosong filesystem ext4 tanpa bergantung pada tmpfs.