
Jadi hari ini saya mencoba mengasah kemampuan troubleshooting, khususnya pada aplikasi yang dapat diimplementasikan secara on-premise seperti mail server (Zimbra dan Carbonio), platform virtualisasi (Proxmox VE), serta file management (Nextcloud). Menurut saya, kemampuan troubleshooting adalah salah satu keterampilan yang harus terus diasah karena sangat dibutuhkan saat mengelola infrastruktur. Namun, ada satu hal yang sampai sekarang masih sering membuat saya bingung ketika ingin belajar troubleshooting, diantara lain:
- Saya gonta-ganti konfigurasinya sendiri (oprek)
- Menunggu ada update/patch/bug terbaru
- atau, menunggu aplikasi failure/error dengan sendirinya
Kalau oprek sendiri dengan skill teknis minim seperti saya malah-malah merembet kemana-mana, kalau menunggu update bisa berbulan-bulan, dan apalagi kalau nunggu aplikasi failure nanti malah tidak latihan.
Masalahnya, menunggu insiden itu tidak efisien. Jadi saya balik logikanya. Saya menjadikan Claude Code untuk merusak lab saya sendiri dengan pola yang realistis, lalu saya yang mendiagnosis dan memperbaiki. Anggap saja latihan tanding, tapi lawannya adalah AI yang paham error apa saja yang biasa terjadi di Proxmox, Nextcloud, Zimbra, atau Carbonio.
Konsepnya
Aturannya cuma satu yang penting: Claude berperan sebagai fasilitator, bukan tukang benerin. Tugas dia merusak, memberi gejala, dan memberi petunjuk kalau saya mentok. Yang mendiagnosis dan memperbaiki tetap saya.
Alurnya kira-kira begini:
- Saya pilih platform dan level kesulitan.
- Claude menyuntikkan satu fault via SSH, tanpa memberi tahu apa yang dia rusak. (sebenernya mau pake MCP tapi belum paham)
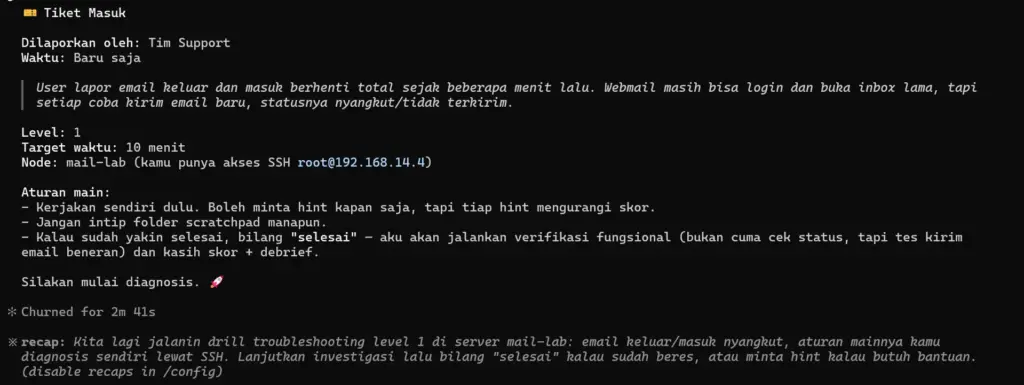
- Saya cuma dikasih gejala, seperti tiket dari user. Misalnya “email keluar nyangkut sejak pagi”.
- Saya investigasi sendiri. Kalau mentok, boleh minta hint, tapi skornya berkurang.
- Setelah saya bilang selesai, Claude verifikasi dan kasih skor.
Kuncinya ada di poin ketiga. Saya tidak dikasih tahu root cause-nya. Persis seperti simulasi production, saya cuma pegang gejala dan harus menelusuri sendiri sampai ke akar.
Level 1 sampai 5
Biar latihannya naik kelas, saya bagi lima level. Makin tinggi, makin dekat ke insiden produksi yang sebenarnya.
| Level | Karakter fault | Contoh |
|---|---|---|
| 1 | Satu masalah jelas, error terang di log | Service ke-stop, typo di config |
| 2 | Satu masalah, gejala kurang gamblang | Port diblok firewall, cert expired |
| 3 | Gejala tak langsung lewat dependensi | LDAP mati bikin semua auth gagal |
| 4 | Cascading, satu akar banyak gejala | Disk penuh, quorum cluster hilang |
| 5 | Beberapa masalah sekaligus, butuh metode | Fault kombinasi lintas layer |
Level 1 itu pemanasan. Level 5 memaksa saya berpikir sistematis, memisahkan gejala satu per satu, dan menahan diri dari asumsi buru-buru.
Penutup: Backup, backup, backup
Sengaja merusak sistem tetap butuh rem. Ada dua aturan yang dibutuhkan
- Pertama, backup atau snapshot dulu sebelum apa pun.
- Kedua, kunci jawaban terpisah di folder sementara. Kalau saya baca duluan, latihan jadi percuma. Biar disiplin aja.
Latihan ini akan dijalankan besok. Stay tune!
Leave a Reply